3. 代码验证
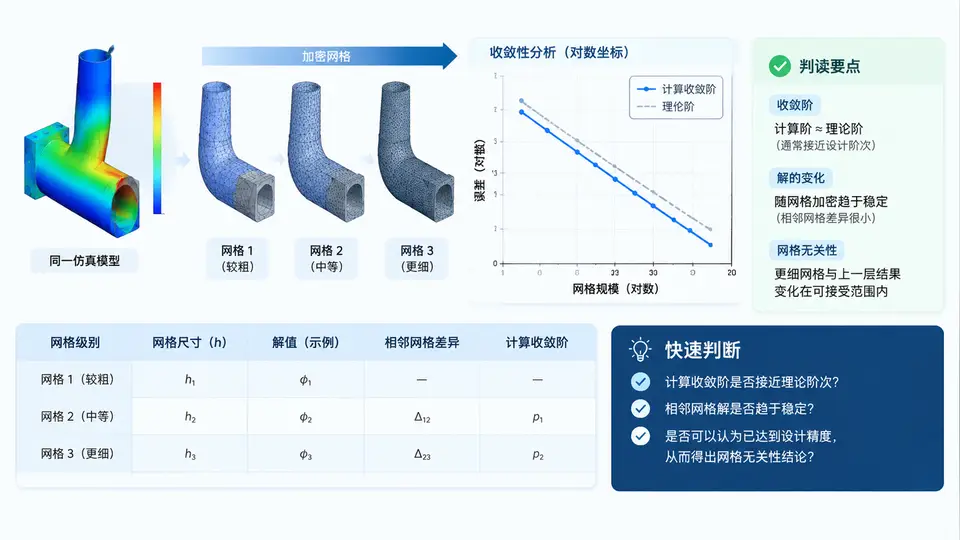
网格收敛性分析的任务定位
网格收敛性分析(Grid Convergence Study)是代码验证中针对空间离散误差的核心手段。它不验证物理模型是否正确,而是回答一个更基础的问题:当网格逐步加密时,数值解是否以理论精度阶收敛到网格无关解。若观测收敛阶与离散格式的理论阶一致,说明空间离散代码实现正确;若显著偏离,则代码可能存在实现缺陷或解未进入渐近收敛区。
本案例以一个二维稳态热传导问题为对象,采用有限体积法离散,中心差分格式,理论空间精度阶 p_theory = 2。通过三套系统加密网格计算离散误差,用 Richardson 外推估计观测收敛阶,并与理论阶比较。
分析对象与离散误差定义
考虑单位正方形区域上的泊松方程:
∇²T = f(x,y),  (x,y) ∈ [0,1]×[0,1]
T = 0,         边界上
选取制造解 T_exact = sin(πx)·sin(πy),对应源项 f = -2π²·sin(πx)·sin(πy)。该解在边界上为零,满足边界条件,且光滑性足够,适合做网格收敛性分析。
离散误差定义为数值解与精确解在网格节点上的 L2 范数:
e_h = sqrt( (1/N) · Σ (T_num,i - T_exact,i)² )其中 N 为节点总数,h 为网格特征尺寸。对均匀网格,h = 1/(n-1),n 为每方向节点数。
网格序列与收敛阶计算
采用三套网格:n = 21、41、81,对应 h = 0.05、0.025、0.0125。网格加密比 r = 2。对每套网格运行求解器,得到离散误差 e₁、e₂、e₃。
观测收敛阶用三点公式计算:
p_obs = log( (e₁/e₂) ) / log(r)   (用前两套网格)
或更稳健的:
p_obs = log( (e₁ - e₂)/(e₂ - e₃) ) / log(r)   (三点公式,适用于单调收敛)
若解处于渐近收敛区,p_obs 应接近理论阶 2。判据:|p_obs - p_theory| ≤ 0.2 视为通过。
教学示例数据(假设由给定离散格式直接推出,非实测):
| 网格 n | h | e_h(L2) | e₁/e₂ 或比值 |
|---|---|---|---|
| 21 | 0.0500 | 3.20e-3 | — |
| 41 | 0.0250 | 8.05e-4 | 3.975 |
| 81 | 0.0125 | 2.02e-4 | 3.985 |
用三点公式:p_obs = log((3.20e-3 - 8.05e-4)/(8.05e-4 - 2.02e-4)) / log(2) = log(2.395/0.603)/log(2) ≈ log(3.972)/0.693 ≈ 1.990。与理论阶 2 的偏差为 0.010,远小于 0.2,判定通过。
网格无关性结论
网格无关性(Grid Independence)指继续加密网格后,关注量(如最大温度、热流密度)的变化小于给定容差。本案例中,用 Richardson 外推估计 h→0 的极限值:
T_extrap ≈ T_3 + (T_3 - T_2)/(r^p - 1)若 |T_3 - T_extrap| / |T_extrap| < 1%,且 p_obs 接近理论阶,则可给出网格无关性结论:n=81 网格已足够,继续加密对结果影响可忽略。
判读要点:收敛阶通过但网格无关性未通过,说明精度阶正确但绝对误差仍偏大,需继续加密;收敛阶不通过,优先检查边界条件实现、源项离散和网格质量,而非盲目加密。
执行要点与常见陷阱
- 网格必须系统加密:加密比 r 保持常数(通常取 2 或 √2),避免非均匀加密导致收敛阶估计失真。
- 确保进入渐近收敛区:最粗网格的误差应足够小,使高阶项可忽略。若 p_obs 随网格变化,说明尚未进入渐近区,需继续加密。
- 误差范数选择:L2 范数对整体误差敏感,L∞ 范数对局部最大误差敏感。代码验证通常用 L2,网格无关性关注量可用 L∞。
- 不要用同一套网格反复计算:必须实际生成不同分辨率的网格并独立求解,不能通过插值伪造。
- 边界条件处理:边界节点误差通常比内部节点大,若边界处理降阶,整体收敛阶会被拉低。可分别统计内部与边界误差定位问题。
注意:本案例中的误差数据为教学示例,用于演示收敛阶计算与判读逻辑,并非实际运行结果。实际分析中应以求解器输出的真实误差为准。若 p_obs 与理论阶偏差超过 0.2,不要直接判定代码错误,先排除网格未进入渐近区、边界条件降阶、源项离散不一致等常见原因。