1. RISC-V向量扩展环境搭建与首个向量程序
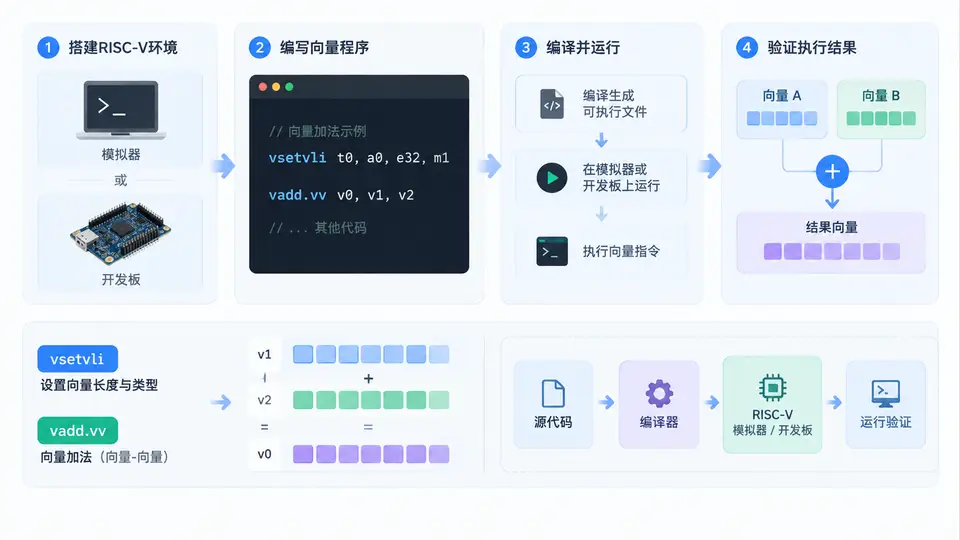
任务目标
本案例使用RISC-V向量扩展指令(V扩展)实现两个整数向量的逐元素加法。通过内联汇编方式,在支持V扩展的RISC-V环境中完成向量加载、向量加法和向量存储操作,并与标量计算结果比对以验证正确性。
环境要求
- 支持RISC-V V扩展(向量扩展)的编译器:GCC 12+(需启用
-march=rv64gcv) - 支持V扩展的模拟器或硬件环境(如QEMU 7.0+,或RISC-V FPGA平台)
- Linux环境(用于编译和运行测试程序)
核心实现
以下代码定义了两个长度为8的整数向量,使用向量指令完成逐元素加法,并通过标量循环验证结果。向量长度固定为8,对应vlen=128位时SEW=32可容纳8个元素;若硬件向量长度不同,代码通过vsetvli动态获取实际处理元素数,并循环处理剩余元素,保证可移植性。
#include <stdio.h>
#include <stdint.h>
#include <string.h>

#define N 8

int main() {
    int32_t a[N] = {1, 2, 3, 4, 5, 6, 7, 8};
    int32_t b[N] = {10, 20, 30, 40, 50, 60, 70, 80};
    int32_t result[N] = {0};
    int32_t expected[N];

    // 标量计算期望结果
    for (int i = 0; i < N; i++) {
        expected[i] = a[i] + b[i];
    }

    // 向量加法:处理长度为N的数组
    size_t len = N;
    int32_t *pa = a, *pb = b, *pr = result;

    while (len > 0) {
        size_t vl;
        asm volatile(
            "vsetvli %0, %1, e32, m1\n"   // 设置向量长度(按32位元素)
            "vle32.v v1, (%2)\n"          // 加载a[i..i+vl-1]
            "vle32.v v2, (%3)\n"          // 加载b[i..i+vl-1]
            "vadd.vv v3, v1, v2\n"        // 向量加法
            "vse32.v v3, (%4)\n"          // 存储结果
            : "=&r"(vl)                    // 输出:实际处理的元素数
            : "r"(len), "r"(pa), "r"(pb), "r"(pr)
            : "v1", "v2", "v3", "memory");

        pa += vl;
        pb += vl;
        pr += vl;
        len -= vl;
    }

    // 验证结果
    int ok = 1;
    for (int i = 0; i < N; i++) {
        if (result[i] != expected[i]) {
            printf("Mismatch at index %d: got %d, expected %d\n",
                   i, result[i], expected[i]);
            ok = 0;
        }
    }

    if (ok) {
        printf("Vector add test PASSED\n");
    } else {
        printf("Vector add test FAILED\n");
    }

    return ok ? 0 : 1;
}
编译与运行
# 编译(需RISC-V GCC工具链)
riscv64-unknown-linux-gnu-gcc -march=rv64gcv -mabi=lp64d -static -O2 -o vec_add vec_add.c

# 在QEMU中运行(需支持V扩展)
qemu-riscv64 -cpu rv64,v=true,vlen=128 ./vec_add
验证方法
程序运行后,若输出Vector add test PASSED且退出码为0,则说明向量加法结果与标量计算结果完全一致,验证通过。若输出FAILED并显示不匹配的索引和值,则说明向量指令执行结果有误,需检查编译参数或模拟器V扩展支持情况。
预期输出(当向量指令正确执行时):
Vector add test PASSED
关键说明
vsetvli指令根据硬件向量长度(VLEN)和元素宽度(SEW=32)自动计算本次循环可处理的元素数,保证代码在不同VLEN的硬件上均可正确运行。- 内联汇编中
"memory"clobber确保编译器不会将数组访问重排到向量指令之前或之后,维持正确的内存访问顺序。 - 本案例使用
m1寄存器组策略(单向量寄存器组),适用于元素数不超过VLEN/32的场景;对于更长数组,循环机制会自动分段处理。