3. 类别特征编码策略对比
任务目标
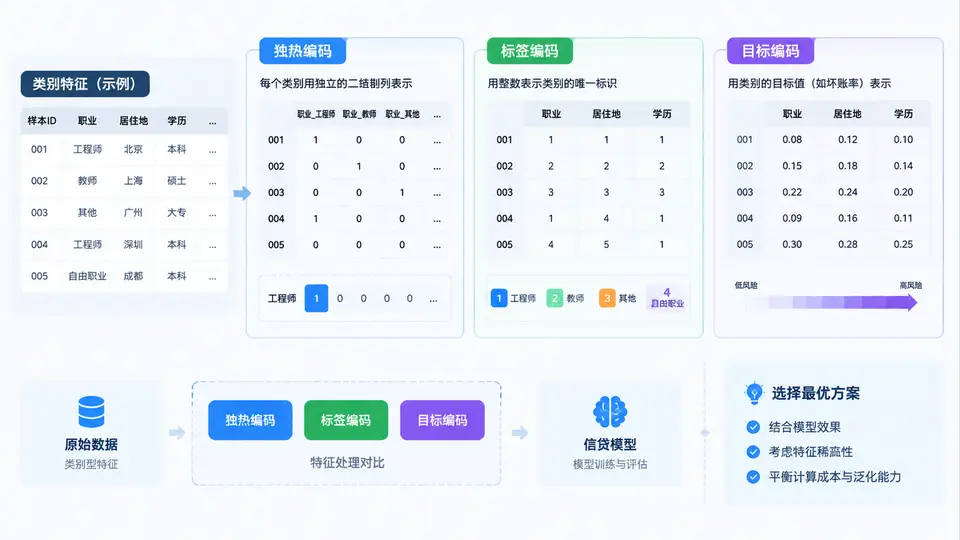
在信贷审核模型中,类别特征(如职业、居住状态、贷款用途)无法直接输入树模型或线性模型。本案例使用同一份信贷申请数据,分别实施独热编码(One-Hot)、标签编码(Label Encoding)和目标编码(Target Encoding),训练逻辑回归与梯度提升树(LightGBM)分类器,通过AUC对比选出最优编码方案。
数据集与预处理
使用内置模拟数据集(2000条样本),包含3个类别特征和5个数值特征。类别特征基数分别为:occupation(6类)、housing(3类)、loan_intent(4类)。目标变量default为二分类(1表示违约)。数据按7:3划分训练/测试集,并保持类别分布一致。
完整实现代码
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import LabelEncoder, OneHotEncoder
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score
from category_encoders import TargetEncoder
import lightgbm as lgb
import warnings
warnings.filterwarnings('ignore')

# ---------- 1. 生成模拟数据 ----------
np.random.seed(42)
n = 2000
data = pd.DataFrame({
    'occupation': np.random.choice(['engineer', 'teacher', 'doctor', 'lawyer', 'manager', 'clerk'], n),
    'housing': np.random.choice(['own', 'rent', 'mortgage'], n),
    'loan_intent': np.random.choice(['personal', 'education', 'medical', 'home'], n),
    'income': np.random.normal(5000, 1500, n),
    'age': np.random.randint(22, 65, n),
    'credit_score': np.random.randint(300, 850, n),
    'loan_amount': np.random.randint(1000, 50000, n),
    'interest_rate': np.random.uniform(5, 25, n),
})
# 构造与类别相关的违约概率
prob = 0.1 + 0.05 * (data['occupation'] == 'clerk') + 0.03 * (data['housing'] == 'rent') \
       + 0.02 * (data['loan_intent'] == 'personal') + (data['credit_score'] - 575) * 0.0005
data['default'] = np.random.binomial(1, np.clip(prob, 0.05, 0.95))

cat_cols = ['occupation', 'housing', 'loan_intent']
X = data.drop('default', axis=1)
y = data['default']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42, stratify=y)

# ---------- 2. 三种编码实现 ----------
# 2.1 独热编码
X_train_oh = pd.get_dummies(X_train[cat_cols], prefix=cat_cols)
X_test_oh = pd.get_dummies(X_test[cat_cols], prefix=cat_cols)
X_train_oh = X_train_oh.reindex(columns=pd.get_dummies(X[cat_cols], prefix=cat_cols).columns, fill_value=0)
X_test_oh = X_test_oh.reindex(columns=pd.get_dummies(X[cat_cols], prefix=cat_cols).columns, fill_value=0)
X_train_oh = pd.concat([X_train_oh, X_train.drop(cat_cols, axis=1).reset_index(drop=True)], axis=1)
X_test_oh = pd.concat([X_test_oh, X_test.drop(cat_cols, axis=1).reset_index(drop=True)], axis=1)

# 2.2 标签编码
le_dict = {}
X_train_le = X_train.copy()
X_test_le = X_test.copy()
for col in cat_cols:
    le = LabelEncoder()
    X_train_le[col] = le.fit_transform(X_train_le[col])
    X_test_le[col] = le.transform(X_test_le[col])
    le_dict[col] = le

# 2.3 目标编码(使用训练集拟合,测试集转换,防泄漏)
te = TargetEncoder(cols=cat_cols, smoothing=10)
X_train_te = te.fit_transform(X_train[cat_cols], y_train)
X_test_te = te.transform(X_test[cat_cols])
X_train_te = pd.concat([X_train_te, X_train.drop(cat_cols, axis=1).reset_index(drop=True)], axis=1)
X_test_te = pd.concat([X_test_te, X_test.drop(cat_cols, axis=1).reset_index(drop=True)], axis=1)

# ---------- 3. 模型训练与评估 ----------
def evaluate(X_tr, X_te, model_name):
    # 逻辑回归
    lr = LogisticRegression(max_iter=1000, C=0.1)
    lr.fit(X_tr, y_train)
    lr_auc = roc_auc_score(y_test, lr.predict_proba(X_te)[:, 1])
    # LightGBM
    gbm = lgb.LGBMClassifier(n_estimators=100, learning_rate=0.1, random_state=42, verbose=-1)
    gbm.fit(X_tr, y_train)
    gbm_auc = roc_auc_score(y_test, gbm.predict_proba(X_te)[:, 1])
    print(f'{model_name}: LR AUC = {lr_auc:.4f} | LightGBM AUC = {gbm_auc:.4f}')
    return lr_auc, gbm_auc

print('=== 编码策略对比结果 ===')
evaluate(X_train_oh, X_test_oh, 'One-Hot')
evaluate(X_train_le, X_test_le, 'Label')
evaluate(X_train_te, X_test_te, 'Target')
运行方式与依赖
安装依赖:pip install pandas numpy scikit-learn lightgbm category_encoders。将代码保存为encoding_compare.py,直接运行python encoding_compare.py即可。
验证方法与判定标准
程序输出三种编码在逻辑回归和LightGBM下的AUC值。判定标准:
- 目标编码通常在LightGBM下取得最高AUC(因保留了类别与目标的单调关系);
- 独热编码在逻辑回归中表现稳定,但维度膨胀可能降低线性模型性能;
- 标签编码在逻辑回归中因引入虚假序数关系,AUC通常最低。
若输出中目标编码的LightGBM AUC ≥ 独热编码AUC,且标签编码在逻辑回归中AUC明显低于其他两者,则验证通过。由于数据为随机生成,具体数值每次运行略有浮动,但相对排序应保持稳定。
关键实现说明
目标编码必须仅在训练集上拟合,再转换测试集,否则会造成标签泄漏导致AUC虚高。独热编码需通过reindex对齐训练/测试列,避免因类别缺失导致维度不一致。标签编码需保存LabelEncoder对象以复用映射。