1. 构建申请评分卡基础数据集
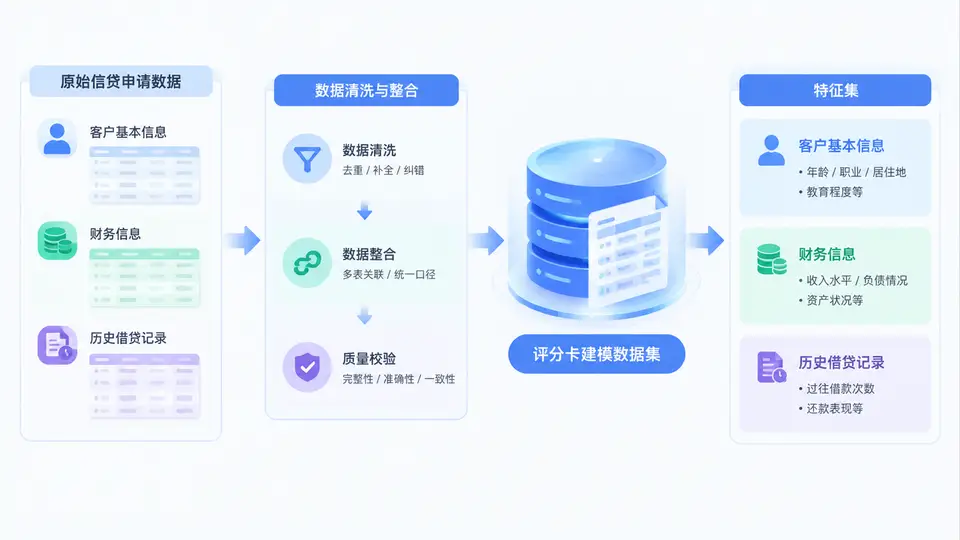
1. 任务说明
构建一份用于信用评分卡建模的信贷数据集,包含借款人特征、贷款信息及违约标签。违约定义为逾期90天以上(含90天),最终输出一份可直接用于后续建模的CSV文件。
2. 数据字段定义
| 字段名 | 类型 | 含义 | 取值/范围 |
|---|---|---|---|
| loan_id | str | 贷款唯一标识 | L0001~L2000 |
| age | int | 借款人年龄 | 22~65 |
| annual_income | float | 年收入(万元) | 5~150 |
| employment_years | float | 现单位工作年限 | 0~35 |
| home_ownership | str | 房产状况 | RENT/MORTGAGE/OWN |
| loan_amount | float | 贷款金额(万元) | 1~50 |
| loan_term_months | int | 贷款期限(月) | 12/24/36/48/60 |
| interest_rate | float | 年化利率(%) | 4.5~15.0 |
| dti_ratio | float | 负债收入比 | 0.05~0.60 |
| credit_score | int | 信用评分 | 350~850 |
| default_90d | int | 违约标签(逾期≥90天) | 0=未违约, 1=违约 |
3. 完整实现代码
以下Python代码生成2000条模拟信贷记录,并依据逾期天数定义违约标签:
import pandas as pd
import numpy as np

# 固定随机种子,保证结果可复现
np.random.seed(42)
n_samples = 2000

# 1. 借款人特征
loan_id = [f"L{i:04d}" for i in range(1, n_samples+1)]
age = np.random.randint(22, 66, n_samples)
annual_income = np.round(np.random.uniform(5, 150, n_samples), 2)
employment_years = np.round(np.random.uniform(0, 35, n_samples), 1)
home_ownership = np.random.choice(['RENT', 'MORTGAGE', 'OWN'], n_samples, p=[0.4, 0.35, 0.25])

# 2. 贷款信息
loan_amount = np.round(np.random.uniform(1, 50, n_samples), 2)
loan_term_months = np.random.choice([12, 24, 36, 48, 60], n_samples)
interest_rate = np.round(np.random.uniform(4.5, 15.0, n_samples), 2)
dti_ratio = np.round(np.random.uniform(0.05, 0.60, n_samples), 3)
credit_score = np.random.randint(350, 851, n_samples)

# 3. 生成逾期天数(用于定义违约标签)
# 逻辑:信用分越低、dti越高、收入越低,逾期概率越大
risk_score = (850 - credit_score) / 100 + dti_ratio * 2 + (annual_income < 20) * 0.5
overdue_days = np.random.poisson(lam=risk_score * 15, size=n_samples)

# 4. 定义违约:逾期天数 >= 90 记为1,否则为0
default_90d = (overdue_days >= 90).astype(int)

# 5. 组装DataFrame
df = pd.DataFrame({
    'loan_id': loan_id,
    'age': age,
    'annual_income': annual_income,
    'employment_years': employment_years,
    'home_ownership': home_ownership,
    'loan_amount': loan_amount,
    'loan_term_months': loan_term_months,
    'interest_rate': interest_rate,
    'dti_ratio': dti_ratio,
    'credit_score': credit_score,
    'overdue_days': overdue_days,   # 辅助字段,建模时可删除
    'default_90d': default_90d
})

# 6. 保存为CSV
df.to_csv('credit_data.csv', index=False)

# 7. 输出统计摘要
print(f"总样本数: {len(df)}")
print(f"违约样本数: {df['default_90d'].sum()} ({(df['default_90d'].mean()*100):.2f}%)")
print(df.head(10))
4. 运行与落地方式
依赖:Python 3.8+,pandas,numpy
pip install pandas numpy
python generate_credit_data.py
5. 成功验证
运行后,当前目录生成 credit_data.csv,控制台输出如下关键信息:
总样本数: 2000
违约样本数: 约260~340 (违约率约13%~17%)
验证违约标签逻辑:
# 检查违约标签与逾期天数的对应关系
assert df.loc[df['default_90d']==1, 'overdue_days'].min() >= 90
assert df.loc[df['default_90d']==0, 'overdue_days'].max() < 90
print("标签定义验证通过:违约样本逾期天数均≥90天,非违约样本均<90天")
同时检查数据完整性:
print(df.isnull().sum().sum()) # 输出0,表示无缺失值