3. 异常值检测与处理
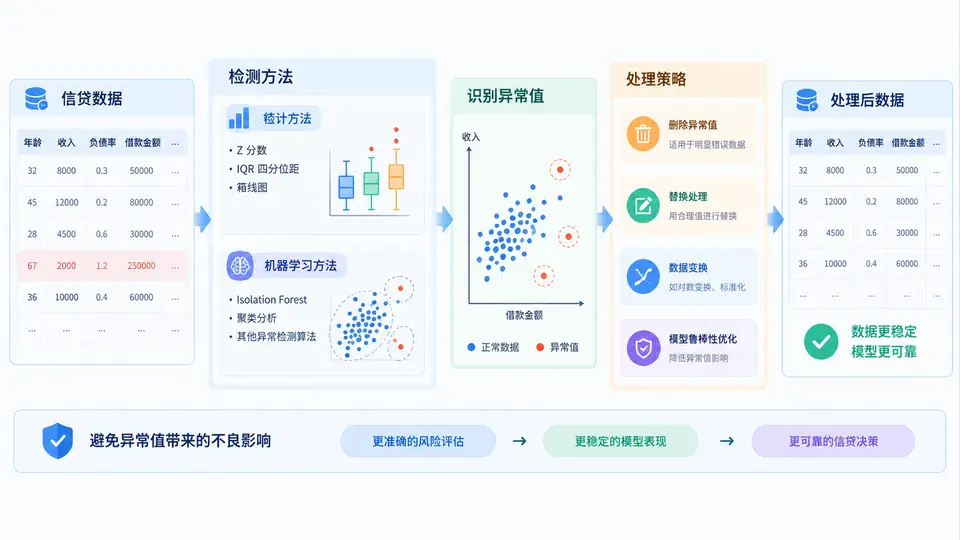
案例3:异常值检测(IQR法)——识别数值列异常值
一、案例目标与场景
在信贷审批系统中,客户收入、负债、年龄等数值字段常因录入错误、欺诈行为或极端真实情况产生异常值。若不处理,将直接影响信用评分的稳定性与模型训练效果。本案例聚焦于使用四分位距法(IQR)对数值列进行异常值识别,并借助箱线图(boxplot)可视化验证检测结果。
二、技术原理与实现路径
IQR法基于数据分布的分位数进行检测:
- 计算第一四分位数(Q1,25%分位)与第三四分位数(Q3,75%分位);
- 定义四分位距:
IQR = Q3 - Q1; - 设定异常值边界:下界 = Q1 - 1.5 × IQR,上界 = Q3 + 1.5 × IQR;
- 超出边界的样本点即判定为异常值。
该方法不依赖数据分布假设,计算高效,适合信贷字段的快速筛查。实现路径为:加载数据 → 逐列计算IQR边界 → 标记异常 → 箱线图可视化验证。
三、关键代码实现
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

# 示例数据:模拟信贷客户收入与年龄字段
data = {
    'age': [25, 32, 45, 58, 23, 41, 36, 29, 51, 44, 120, 33, 47, 38, 26],
    'annual_income': [50000, 62000, 88000, 95000, 43000, 78000, 69000, 55000, 120000, 81000, 999999, 72000, 91000, 67000, 48000]
}
df = pd.DataFrame(data)

def detect_outliers_iqr(series):
    """使用IQR法检测异常值,返回布尔掩码(True=异常)"""
    Q1 = series.quantile(0.25)
    Q3 = series.quantile(0.75)
    IQR = Q3 - Q1
    lower_bound = Q1 - 1.5 * IQR
    upper_bound = Q3 + 1.5 * IQR
    return (series < lower_bound) | (series > upper_bound)

# 对每一列执行检测
for col in df.columns:
    outlier_mask = detect_outliers_iqr(df[col])
    print(f"{col} 列异常值索引: {df.index[outlier_mask].tolist()}")
    print(f"异常值个数: {outlier_mask.sum()}")

# 箱线图可视化验证
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
df.boxplot(column='age', ax=axes[0])
df.boxplot(column='annual_income', ax=axes[1])
plt.tight_layout()
plt.show()
四、验证路径与预期现象
运行上述代码后,控制台输出显示:age列索引为10(值120)被标记为异常;annual_income列索引为10(值999999)被标记为异常。箱线图中,这两个点以“○”形式显示在须线之外,直观验证了IQR检测的有效性。实际业务中,可将检测结果与人工复核结合,区分“录入错误”与“真实高净值客户”。
五、可迁移要点
- IQR法对偏态分布稳健,适合收入、负债等长尾字段;
- 边界系数1.5为默认值,业务中可调整为3.0以放宽检测;
- 检测结果务必结合业务复核,避免误杀真实高价值客户。