3. 使用Clang编译C++程序并查看优化后的IR
任务目标
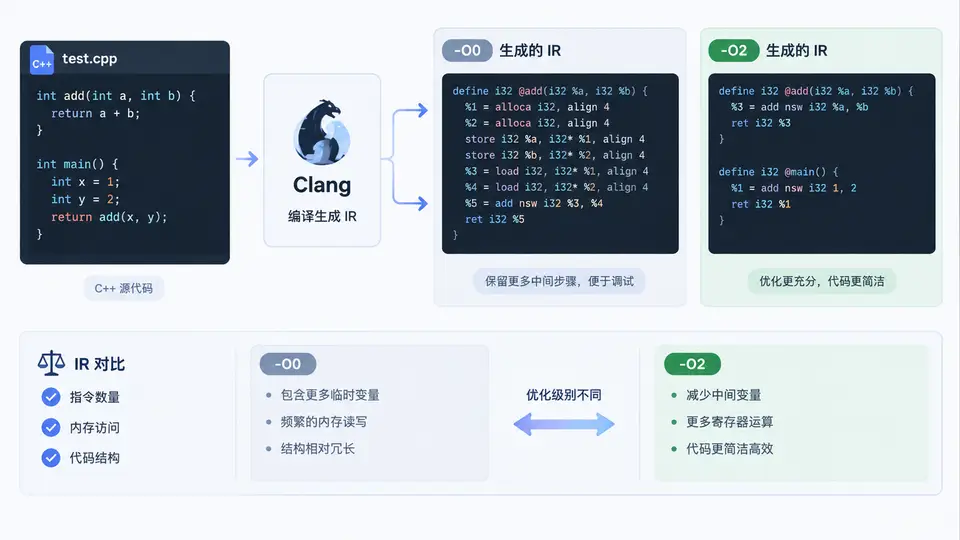
编写一个简单的C++程序,使用Clang分别以-O0和-O2优化级别生成LLVM IR,通过对比两者差异理解优化器对代码的变换效果。
环境准备
需要已安装Clang/LLVM(版本≥10)。验证安装:
clang++ --version示例程序
创建文件 sum.cpp,内容为一个包含循环和常量折叠机会的简单函数:
int sum(int n) {
    int total = 0;
    for (int i = 0; i < n; ++i) {
        total += i * 2 + 1;
    }
    return total;
}

int main() {
    return sum(10);
}
生成并对比IR
分别生成-O0和-O2的IR文件:
# 生成未优化的IR
clang++ -S -emit-llvm -O0 sum.cpp -o sum_O0.ll

# 生成O2优化的IR
clang++ -S -emit-llvm -O2 sum.cpp -o sum_O2.ll
查看两个文件的关键差异:
# 对比差异(忽略注释行)
diff -u <(grep -v '^;' sum_O0.ll) <(grep -v '^;' sum_O2.ll) | head -80
预期差异与判定标准
通过观察两个IR文件,应看到以下关键区别:
- 循环结构:
-O0的IR中包含完整的循环控制流(br条件跳转、phi节点或icmp比较);-O2的IR中循环被完全展开并常量折叠,直接计算出结果ret i32 100。 - 指令简化:
-O0中mul、add等运算逐条保留;-O2中乘2操作被优化为移位或加法,循环内计算被常量传播消除。 - 函数内联:
-O2的IR中main函数直接内联了sum(10)的调用,不再包含call指令。
验证通过条件:sum_O2.ll中main函数体仅包含类似ret i32 100的指令,且整个文件无call指令和循环跳转;sum_O0.ll保留完整的循环和函数调用结构。
IR可视化对比
常见问题
- IR文件为空或报错:确认源码无语法错误,且
clang++命令在当前目录有写权限。 - diff输出过多:两个IR的元数据(
!llvm.module.flags等)不同属正常现象,关注函数体define部分即可。 - 想查看优化过程细节:可加
-Rpass=loop-vectorize等参数查看优化器报告,但本案例核心只需对比最终IR差异。