1. PPO在CartPole上的首次实现
任务目标
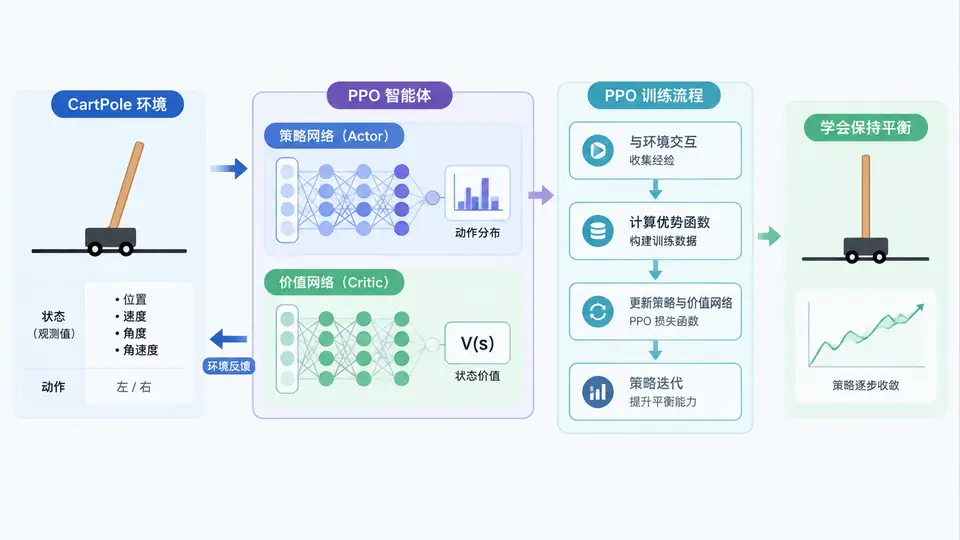
使用PyTorch从零实现PPO(Proximal Policy Optimization)算法,在 Gym的CartPole-v1环境中训练一个策略网络,使智能体学会平衡倒立摆。通过本案例理解PPO中策略网络(Actor)与价值网络(Critic)如何协同工作:Actor输出动作概率分布,Critic估计状态价值用于计算优势函数,并利用重要性采样与裁剪目标限制策略更新幅度。
环境与依赖
- Python 3.8+
- PyTorch 1.12+
- gymnasium(或经典gym 0.21+,接口略有差异)
- numpy
安装命令:pip install torch gymnasium numpy
核心实现
以下代码完整实现了PPO算法的训练闭环。策略网络输出动作概率分布(CartPole为离散二动作),价值网络输出状态标量价值。训练循环中,智能体先与环境交互收集一批轨迹,然后计算优势估计(GAE),最后用裁剪的PPO目标更新网络参数。
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F
import numpy as np
import gymnasium as gym

# ---------- 超参数 ----------
GAMMA = 0.99
LAMBDA = 0.95
CLIP_EPS = 0.2
EPOCHS = 4
BATCH_SIZE = 64
LR = 3e-4
MAX_STEPS = 2000        # 总训练步数
ROLLOUT_STEPS = 512     # 每次收集轨迹长度

# ---------- 网络定义 ----------
class ActorCritic(nn.Module):
    def __init__(self, obs_dim, act_dim):
        super().__init__()
        self.shared = nn.Sequential(
            nn.Linear(obs_dim, 64), nn.Tanh(),
            nn.Linear(64, 64), nn.Tanh()
        )
        self.policy = nn.Linear(64, act_dim)
        self.value = nn.Linear(64, 1)

    def forward(self, obs):
        x = self.shared(obs)
        logits = self.policy(x)
        value = self.value(x).squeeze(-1)
        return logits, value

    def act(self, obs):
        logits, _ = self.forward(obs)
        dist = torch.distributions.Categorical(logits=logits)
        action = dist.sample()
        return action.item(), dist.log_prob(action)

    def evaluate(self, obs, actions):
        logits, value = self.forward(obs)
        dist = torch.distributions.Categorical(logits=logits)
        log_prob = dist.log_prob(actions)
        entropy = dist.entropy().mean()
        return log_prob, entropy, value

# ---------- 经验缓冲区 ----------
class RolloutBuffer:
    def __init__(self):
        self.states = []
        self.actions = []
        self.log_probs = []
        self.rewards = []
        self.dones = []
        self.values = []

    def store(self, s, a, lp, r, d, v):
        self.states.append(s)
        self.actions.append(a)
        self.log_probs.append(lp)
        self.rewards.append(r)
        self.dones.append(d)
        self.values.append(v)

    def clear(self):
        self.__init__()

# ---------- PPO训练 ----------
def train_ppo():
    env = gym.make("CartPole-v1")
    obs_dim = env.observation_space.shape[0]
    act_dim = env.action_space.n

    model = ActorCritic(obs_dim, act_dim)
    optimizer = optim.Adam(model.parameters(), lr=LR)
    buffer = RolloutBuffer()

    obs, _ = env.reset()
    episode_reward = 0
    episode_count = 0
    best_reward = 0

    for step in range(MAX_STEPS):
        # 收集轨迹
        for _ in range(ROLLOUT_STEPS):
            obs_t = torch.FloatTensor(obs)
            action, log_prob = model.act(obs_t)
            value = model.forward(obs_t)[1].item()

            next_obs, reward, terminated, truncated, _ = env.step(action)
            done = terminated or truncated

            buffer.store(obs, action, log_prob, reward, done, value)
            episode_reward += reward
            obs = next_obs

            if done:
                obs, _ = env.reset()
                episode_count += 1
                if episode_reward > best_reward:
                    best_reward = episode_reward
                episode_reward = 0

        # 计算优势并更新
        obs_t = torch.FloatTensor(obs)
        _, last_value = model.forward(obs_t)
        last_value = last_value.item()

        states = torch.FloatTensor(np.array(buffer.states))
        actions = torch.LongTensor(np.array(buffer.actions))
        old_log_probs = torch.FloatTensor(np.array(buffer.log_probs))
        rewards = np.array(buffer.rewards)
        dones = np.array(buffer.dones)
        values = np.array(buffer.values)

        # GAE优势估计
        advantages = np.zeros_like(rewards)
        gae = 0
        for t in reversed(range(len(rewards))):
            if t == len(rewards) - 1:
                next_value = last_value
            else:
                next_value = values[t + 1]
            delta = rewards[t] + GAMMA * next_value * (1 - dones[t]) - values[t]
            gae = delta + GAMMA * LAMBDA * (1 - dones[t]) * gae
            advantages[t] = gae
        returns = advantages + values

        advantages_t = torch.FloatTensor(advantages)
        returns_t = torch.FloatTensor(returns)

        # 多轮更新
        for _ in range(EPOCHS):
            indices = torch.randperm(len(states))
            for start in range(0, len(states), BATCH_SIZE):
                idx = indices[start:start + BATCH_SIZE]
                batch_states = states[idx]
                batch_actions = actions[idx]
                batch_old_log_probs = old_log_probs[idx]
                batch_advantages = advantages_t[idx]
                batch_returns = returns_t[idx]

                log_probs, entropy, values_pred = model.evaluate(batch_states, batch_actions)
                ratio = torch.exp(log_probs - batch_old_log_probs)

                surr1 = ratio * batch_advantages
                surr2 = torch.clamp(ratio, 1 - CLIP_EPS, 1 + CLIP_EPS) * batch_advantages
                policy_loss = -torch.min(surr1, surr2).mean()
                value_loss = F.mse_loss(values_pred, batch_returns)
                loss = policy_loss + 0.5 * value_loss - 0.01 * entropy

                optimizer.zero_grad()
                loss.backward()
                optimizer.step()

        buffer.clear()

        if (step + 1) % 200 == 0:
            print(f"Step {step+1}, Episodes: {episode_count}, Best Reward: {best_reward}")

    env.close()
    print(f"训练完成。共完成 {episode_count} 个episode,最佳奖励: {best_reward}")

if __name__ == "__main__":
    train_ppo()
运行与验证
- 将上述代码保存为
ppo_cartpole.py,直接运行python ppo_cartpole.py。 - 训练过程中每200步打印一次当前进度。CartPole-v1的奖励阈值是500(即智能体成功平衡500步即视为解决任务)。
- 通过判定标准:训练结束后,若打印的
Best Reward达到或接近500(通常需要训练约1000~2000步),说明PPO算法成功解决了CartPole任务。若最佳奖励持续低于200,可尝试增大MAX_STEPS至5000或调整学习率。
关键理解点
- Actor-Critic配合:Actor(策略网络)根据状态输出动作概率;Critic(价值网络)输出状态价值,用于计算优势函数
A = Q - V,衡量当前动作相对平均水平的优劣。 - 裁剪目标:
ratio是新旧策略的概率比,裁剪到[1-ε, 1+ε]防止更新步长过大,这是PPO稳定训练的核心机制。 - GAE优势估计:代码中使用广义优势估计(GAE)在偏差与方差间取得平衡,
LAMBDA控制权衡。
上图展示了PPO的训练闭环:智能体在环境中采样轨迹存入缓冲区,然后从缓冲区取批量数据,利用Critic网络计算的优势函数更新Actor与Critic参数,更新后的网络继续与环境交互,循环往复直至策略收敛。