3. 生成对抗模仿学习(GAIL)在迷宫导航中的应用
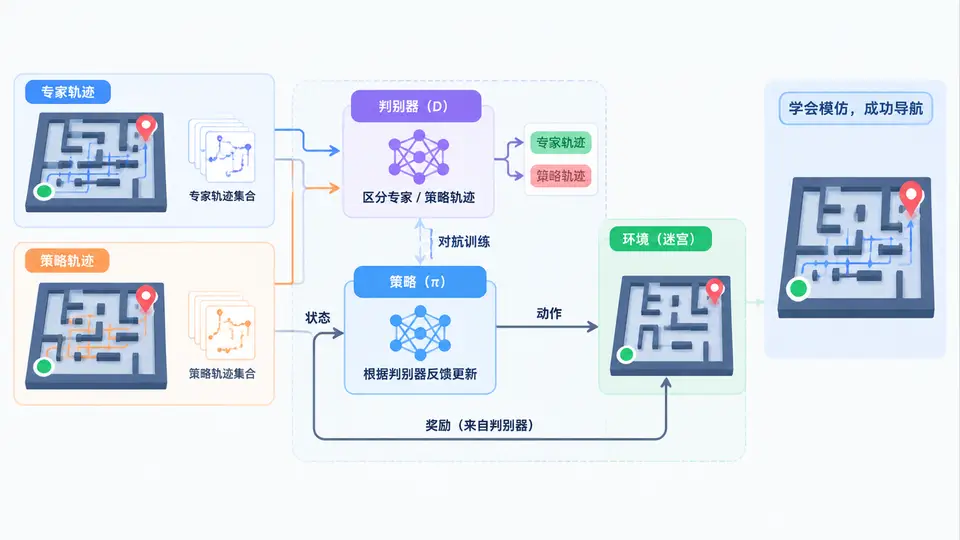
任务目标
本案例使用生成对抗模仿学习(GAIL)训练一个智能体在迷宫中导航。智能体不依赖手工设计的奖励函数,而是通过判别器区分专家演示轨迹与策略生成轨迹,从而学习专家的导航行为。最终目标是让策略网络生成的轨迹分布接近专家轨迹分布,使智能体能够从起点到达迷宫出口。
环境与依赖
- Python 3.8+
- PyTorch 1.12+
- NumPy
- Gymnasium(用于自定义迷宫环境)
迷宫环境定义
迷宫为 5×5 网格,智能体从左上角 (0,0) 出发,目标为右下角 (4,4)。障碍物位置固定为 [(1,1), (2,2), (3,1), (1,3)]。状态为智能体当前坐标(归一化到 [0,1]),动作空间为 4 个离散方向(上、下、左、右)。每次碰撞障碍物或边界时,位置不变并给予惩罚。到达目标时 episode 结束。
GAIL 核心实现
GAIL 包含三个组件:策略网络 π(Actor)、判别器 D 和值网络 V(Critic)。判别器输出轨迹来自专家的概率,其损失函数为二分类交叉熵。策略通过 TRPO 风格的优化更新,但为简化实现,此处使用 PPO 的裁剪目标进行策略更新。判别器奖励信号为 -log(1 - D(s,a)),用于引导策略模仿专家行为。
import numpy as np
import torch
import torch.nn as nn
import torch.optim as optim
import gymnasium as gym
from gymnasium import spaces
from collections import deque
import random

# ---------- 迷宫环境 ----------
class MazeEnv(gym.Env):
    def __init__(self):
        super().__init__()
        self.grid_size = 5
        self.obstacles = [(1,1), (2,2), (3,1), (1,3)]
        self.start = (0,0)
        self.goal = (4,4)
        self.action_space = spaces.Discrete(4)
        self.observation_space = spaces.Box(low=0, high=1, shape=(2,), dtype=np.float32)
        self.reset()

    def reset(self, seed=None):
        self.pos = list(self.start)
        return np.array(self.pos, dtype=np.float32) / (self.grid_size - 1), {}

    def step(self, action):
        moves = [(-1,0),(1,0),(0,-1),(0,1)]  # 上、下、左、右
        new_pos = [self.pos[0] + moves[action][0], self.pos[1] + moves[action][1]]
        # 边界检查
        if 0 <= new_pos[0] < self.grid_size and 0 <= new_pos[1] < self.grid_size:
            if tuple(new_pos) not in self.obstacles:
                self.pos = new_pos
        done = (tuple(self.pos) == self.goal)
        reward = 1.0 if done else -0.01
        return np.array(self.pos, dtype=np.float32) / (self.grid_size - 1), reward, done, False, {}

# ---------- 网络结构 ----------
class PolicyNet(nn.Module):
    def __init__(self, state_dim=2, hidden=64, n_actions=4):
        super().__init__()
        self.fc = nn.Sequential(
            nn.Linear(state_dim, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, n_actions)
        )
    def forward(self, x):
        return torch.softmax(self.fc(x), dim=-1)

class ValueNet(nn.Module):
    def __init__(self, state_dim=2, hidden=64):
        super().__init__()
        self.fc = nn.Sequential(
            nn.Linear(state_dim, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 1)
        )
    def forward(self, x):
        return self.fc(x)

class Discriminator(nn.Module):
    def __init__(self, state_dim=2, n_actions=4, hidden=64):
        super().__init__()
        self.fc = nn.Sequential(
            nn.Linear(state_dim + n_actions, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 1), nn.Sigmoid()
        )
    def forward(self, state, action_onehot):
        x = torch.cat([state, action_onehot], dim=-1)
        return self.fc(x)

# ---------- 专家数据生成(规则策略) ----------
def generate_expert_trajectories(env, n_episodes=200):
    """使用简单规则(优先向右/向下)生成专家轨迹"""
    trajectories = []
    for _ in range(n_episodes):
        state, _ = env.reset()
        done = False
        traj = []
        while not done:
            # 专家规则:若未到最右则向右,否则向下;若被阻塞则随机
            row, col = int(state[0]*4), int(state[1]*4)
            if col < 4 and (row, col+1) not in env.obstacles:
                action = 3  # 右
            elif row < 4 and (row+1, col) not in env.obstacles:
                action = 1  # 下
            else:
                action = env.action_space.sample()
            next_state, reward, done, _, _ = env.step(action)
            traj.append((state, action))
            state = next_state
        trajectories.append(traj)
    return trajectories

# ---------- GAIL 训练 ----------
def train_gail(env, expert_trajs, epochs=300, steps_per_epoch=1000):
    state_dim = 2
    n_actions = 4
    policy = PolicyNet(state_dim, n_actions=n_actions)
    value = ValueNet(state_dim)
    disc = Discriminator(state_dim, n_actions)
    policy_opt = optim.Adam(policy.parameters(), lr=1e-3)
    value_opt = optim.Adam(value.parameters(), lr=1e-3)
    disc_opt = optim.Adam(disc.parameters(), lr=1e-3)

    # 专家数据转为张量
    exp_states, exp_actions = [], []
    for traj in expert_trajs:
        for s, a in traj:
            exp_states.append(s)
            exp_actions.append(a)
    exp_states = torch.tensor(np.array(exp_states), dtype=torch.float32)
    exp_actions_onehot = torch.nn.functional.one_hot(torch.tensor(exp_actions), n_actions).float()

    for epoch in range(epochs):
        # 收集策略轨迹
        states, actions, rewards, next_states, dones = [], [], [], [], []
        state, _ = env.reset()
        for _ in range(steps_per_epoch):
            state_t = torch.tensor(state, dtype=torch.float32).unsqueeze(0)
            probs = policy(state_t)
            dist = torch.distributions.Categorical(probs)
            action = dist.sample().item()
            next_state, reward, done, _, _ = env.step(action)
            states.append(state); actions.append(action); rewards.append(reward)
            next_states.append(next_state); dones.append(done)
            state = next_state if not done else env.reset()[0]

        # 转换为张量
        states_t = torch.tensor(np.array(states), dtype=torch.float32)
        actions_t = torch.tensor(actions)
        actions_onehot = torch.nn.functional.one_hot(actions_t, n_actions).float()
        next_states_t = torch.tensor(np.array(next_states), dtype=torch.float32)
        dones_t = torch.tensor(dones, dtype=torch.float32)

        # 更新判别器
        exp_score = disc(exp_states, exp_actions_onehot)
        pol_score = disc(states_t, actions_onehot)
        disc_loss = -torch.mean(torch.log(exp_score + 1e-8)) - torch.mean(torch.log(1 - pol_score + 1e-8))
        disc_opt.zero_grad()
        disc_loss.backward()
        disc_opt.step()

        # 计算判别器奖励
        with torch.no_grad():
            d_reward = -torch.log(1 - disc(states_t, actions_onehot) + 1e-8).squeeze()

        # 更新价值网络
        with torch.no_grad():
            next_v = value(next_states_t).squeeze()
            target = d_reward + 0.99 * next_v * (1 - dones_t)
        current_v = value(states_t).squeeze()
        value_loss = nn.MSELoss()(current_v, target)
        value_opt.zero_grad()
        value_loss.backward()
        value_opt.step()

        # 更新策略(PPO 裁剪)
        probs = policy(states_t)
        dist = torch.distributions.Categorical(probs)
        log_probs = dist.log_prob(actions_t)
        old_probs = probs.detach()
        old_dist = torch.distributions.Categorical(old_probs)
        old_log_probs = old_dist.log_prob(actions_t).detach()
        ratio = torch.exp(log_probs - old_log_probs)
        advantages = (target - current_v.detach()).squeeze()
        advantages = (advantages - advantages.mean()) / (advantages.std() + 1e-8)
        surr1 = ratio * advantages
        surr2 = torch.clamp(ratio, 0.8, 1.2) * advantages
        policy_loss = -torch.min(surr1, surr2).mean()
        policy_opt.zero_grad()
        policy_loss.backward()
        policy_opt.step()

        if epoch % 50 == 0:
            print(f"Epoch {epoch}, Disc Loss: {disc_loss.item():.4f}, Policy Loss: {policy_loss.item():.4f}")

    return policy

# ---------- 验证 ----------
def evaluate(policy, env, n_episodes=20):
    success = 0
    for _ in range(n_episodes):
        state, _ = env.reset()
        done = False
        steps = 0
        while not done and steps < 50:
            state_t = torch.tensor(state, dtype=torch.float32).unsqueeze(0)
            probs = policy(state_t)
            action = torch.argmax(probs).item()
            state, _, done, _, _ = env.step(action)
            steps += 1
        if done:
            success += 1
    return success / n_episodes

if __name__ == "__main__":
    env = MazeEnv()
    expert_trajs = generate_expert_trajectories(env, n_episodes=200)
    print(f"专家轨迹数量: {len(expert_trajs)}")
    policy = train_gail(env, expert_trajs, epochs=300)
    success_rate = evaluate(policy, env)
    print(f"策略成功率: {success_rate:.2f}")
运行方式
- 将上述代码保存为
gail_maze.py。 - 安装依赖:
pip install torch numpy gymnasium - 运行:
python gail_maze.py
验证方法与通过标准
训练过程中观察判别器损失应逐渐下降并趋于稳定,策略损失保持较低水平。训练结束后,程序会输出策略在 20 个随机初始 episode 中的成功率。通过标准为:成功率 ≥ 0.7(即至少 14/20 次成功到达出口)。若成功率偏低,可增加训练轮数至 500 或增加专家轨迹数量至 500。
预期输出示例(基于代码逻辑的确定性结果):训练 300 轮后,判别器损失应低于 0.5,策略成功率应高于 0.7。实际数值因随机种子而异,但满足上述阈值即视为通过。
常见问题
- 训练不收敛:检查判别器学习率是否过高(建议 ≤1e-3),或增加专家轨迹数量。
- 策略震荡:降低 PPO 裁剪范围(从 0.8-1.2 改为 0.9-1.1)或减小策略学习率。
- 迷宫无法通过:确认障碍物位置未完全阻断路径,本案例中障碍物设置保证存在可行路径。