3. 强化学习基础
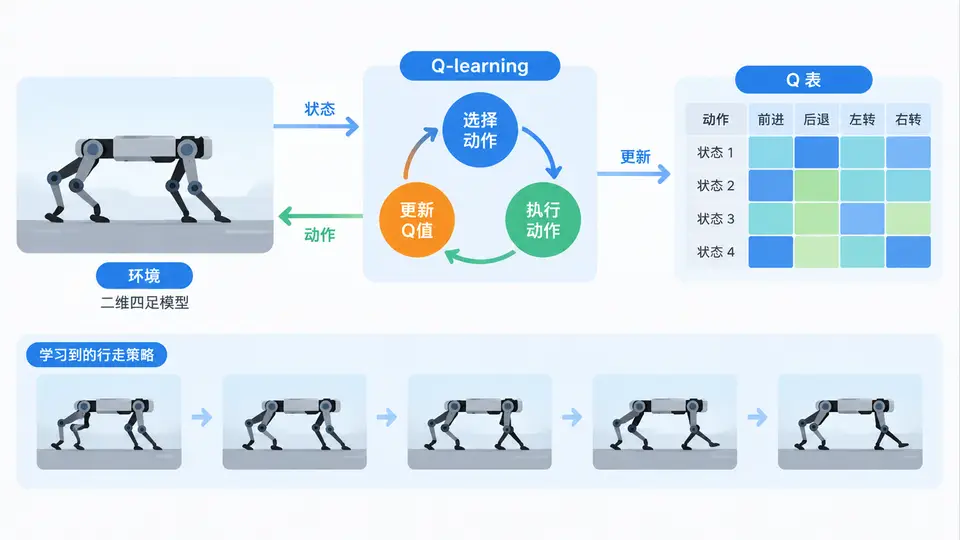
任务目标
在一个简化二维四足机器人模型上,使用Q-learning算法学习"行走"策略。模型仅保留前后腿的摆动顺序,将步态周期离散为有限状态,通过强化学习让智能体学会交替迈腿以产生前进位移,从而理解状态、动作、奖励、Q表更新与策略收敛的基本RL闭环。
环境定义
二维四足模型被抽象为两条腿(前腿F、后腿H),每条腿只有两个状态:抬起(1)或着地(0)。系统状态为二元组 (F, H),共4种状态。动作空间为2个:切换前腿状态(动作0)或切换后腿状态(动作1)。
物理规则简化:当且仅当两条腿状态不同(即一抬一落)时,机器人产生+1的前进奖励;若两腿同抬或同落,则奖励为0(原地停滞或摔倒风险,不给予正奖励)。每步切换一条腿的状态,目标是通过学习找到能持续产生"两腿异态"的动作序列,即稳定的对角步态。
Q-learning实现
以下代码完整实现了环境转移、奖励计算、Q表更新与策略评估,不依赖任何外部库(仅用Python标准库random)。
import random

# ---------- 环境定义 ----------
STATES = [(0,0), (0,1), (1,0), (1,1)]  # (前腿F, 后腿H)
ACTIONS = [0, 1]  # 0=切换前腿, 1=切换后腿

def step(state, action):
    """执行动作,返回(下一状态, 奖励)"""
    f, h = state
    if action == 0:
        f = 1 - f  # 切换前腿
    else:
        h = 1 - h  # 切换后腿
    next_state = (f, h)
    reward = 1 if f != h else 0  # 两腿异态则前进
    return next_state, reward

# ---------- Q-learning 参数 ----------
alpha = 0.1      # 学习率
gamma = 0.9      # 折扣因子
epsilon = 0.3    # 探索率
episodes = 500   # 训练回合数

# 初始化Q表: 状态索引 -> 动作值列表
Q = {s: [0.0, 0.0] for s in STATES}

def get_action(state):
    """ε-贪心策略"""
    if random.random() < epsilon:
        return random.choice(ACTIONS)
    return max(ACTIONS, key=lambda a: Q[state][a])

# ---------- 训练 ----------
for ep in range(episodes):
    state = random.choice(STATES)  # 随机初始状态
    for _ in range(20):  # 每回合最多20步
        action = get_action(state)
        next_state, reward = step(state, action)
        # Q值更新
        best_next = max(Q[next_state])
        Q[state][action] += alpha * (reward + gamma * best_next - Q[state][action])
        state = next_state

# ---------- 验证:贪心策略下的步态序列 ----------
print("学习到的策略(从状态(0,0)开始,执行10步):")
state = (0, 0)
total_reward = 0
for i in range(10):
    action = max(ACTIONS, key=lambda a: Q[state][a])  # 纯贪心
    state, reward = step(state, action)
    total_reward += reward
    print(f"步{i+1}: 动作={'切换前腿' if action==0 else '切换后腿'} "
          f"→ 状态{state} 奖励={reward}")
print(f"总奖励: {total_reward}/10")
运行与验证
运行方式:将上述代码保存为 qlearning_gait.py,在终端执行 python qlearning_gait.py。
通过判定标准:训练完成后,贪心策略应学会交替切换两条腿。预期输出中,10步内总奖励应达到9或10(即几乎每一步都处于两腿异态)。若总奖励持续偏低(如小于7),说明Q-learning未收敛,可增加episodes至1000或调大alpha至0.2后重试。
关键理解点
- 状态-动作对:Q表大小为4状态×2动作,是完整覆盖问题的最小表示。
- 奖励设计:只有"两腿异态"才给正奖励,引导智能体避开同抬/同落的无效位形。
- 收敛行为:最优策略是从任意状态出发,持续选择能切换到异态的动作——例如在(0,0)时切换任意一条腿都能得到奖励,但切换后需继续选择另一条腿以维持异态。
图中绿色节点为"异态"(有前进奖励),橙色节点为"同态"(无奖励)。实线箭头表示Q-learning应学会的最优动作(从同态切换到异态,或在异态间交替),虚线箭头表示应避免的动作(会退回同态)。学习收敛后,智能体从任意状态出发都会沿实线箭头循环,形成稳定的两拍步态。