1. 独立Q学习基线
任务目标
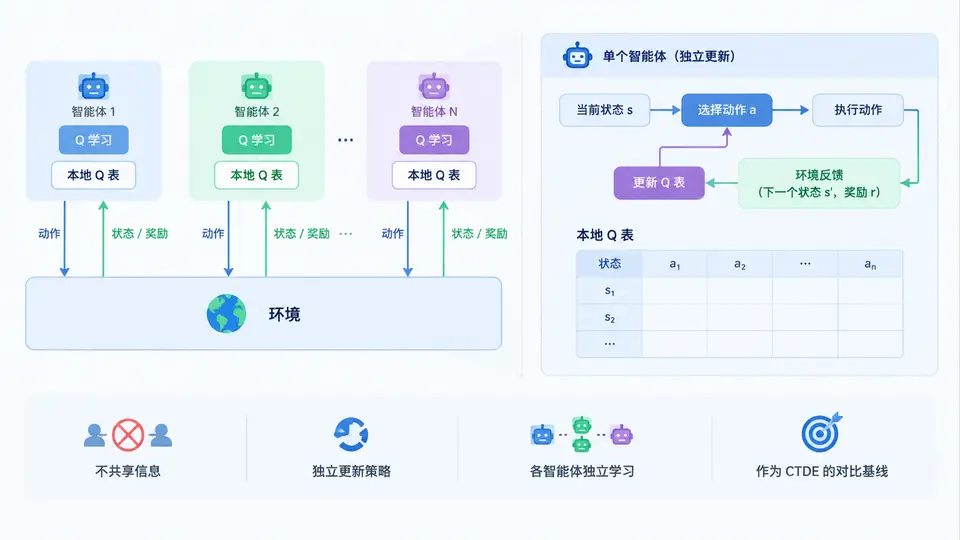
实现一个多智能体环境下的独立Q学习(Independent Q-Learning, IQL)基线:每个智能体仅依据自身观测与奖励,独立维护一张Q表并更新策略,智能体之间不共享任何信息。该基线用于后续与CTDE(集中训练分布式执行)方法进行对比。
环境与依赖
- Python 3.8+,仅需NumPy库(
pip install numpy) - 环境:自定义2智能体“双硬币”博弈(简化版囚徒困境变体),每个智能体可选择合作(C)或背叛(D),奖励矩阵如下:
| 智能体1 \ 智能体2 | C | D |
|---|---|---|
| C | (3, 3) | (0, 5) |
| D | (5, 0) | (1, 1) |
关键完整代码
import numpy as np

class IQLAgent:
    """独立Q学习智能体:仅使用自身观测(即自身上一动作)与自身奖励更新Q表"""
    def __init__(self, n_actions, alpha=0.1, gamma=0.95, epsilon=0.1):
        self.n_actions = n_actions
        self.alpha = alpha
        self.gamma = gamma
        self.epsilon = epsilon
        # 观测空间 = 自身上一动作(2种) + 一个固定起始状态(用0表示)
        self.Q = np.zeros((2, n_actions))  # 行索引: 0=起始, 1=上一动作C, 2=上一动作D

    def get_state(self, last_action):
        """将上一动作映射为状态索引: 无上一动作(起始)->0, C->1, D->2"""
        if last_action is None:
            return 0
        return 1 if last_action == 0 else 2  # 动作0=C, 1=D

    def choose_action(self, state):
        """ε-贪心策略"""
        if np.random.rand() < self.epsilon:
            return np.random.randint(self.n_actions)
        return int(np.argmax(self.Q[state]))

    def update(self, state, action, reward, next_state):
        """Q-learning更新"""
        best_next = np.max(self.Q[next_state])
        td_target = reward + self.gamma * best_next
        self.Q[state, action] += self.alpha * (td_target - self.Q[state, action])

def run_episode(agent1, agent2, n_steps=100):
    """运行一个回合,返回两个智能体的总奖励"""
    last_a1 = last_a2 = None
    total_r1 = total_r2 = 0.0
    # 奖励矩阵: [智能体1动作][智能体2动作] -> (r1, r2)
    reward_matrix = [[(3, 3), (0, 5)],
                     [(5, 0), (1, 1)]]

    for _ in range(n_steps):
        s1 = agent1.get_state(last_a1)
        s2 = agent2.get_state(last_a2)
        a1 = agent1.choose_action(s1)
        a2 = agent2.choose_action(s2)
        r1, r2 = reward_matrix[a1][a2]

        # 更新(使用下一状态,即本次动作后的状态)
        ns1 = agent1.get_state(a1)
        ns2 = agent2.get_state(a2)
        agent1.update(s1, a1, r1, ns1)
        agent2.update(s2, a2, r2, ns2)

        total_r1 += r1
        total_r2 += r2
        last_a1, last_a2 = a1, a2

    return total_r1, total_r2

if __name__ == "__main__":
    # 训练500回合,每回合50步
    agent1 = IQLAgent(n_actions=2)
    agent2 = IQLAgent(n_actions=2)

    for episode in range(500):
        r1, r2 = run_episode(agent1, agent2, n_steps=50)
        if episode % 100 == 0:
            print(f"Episode {episode}: Agent1总奖励={r1:.1f}, Agent2总奖励={r2:.1f}")

    # 训练后测试(关闭探索)
    agent1.epsilon = 0.0
    agent2.epsilon = 0.0
    test_r1, test_r2 = run_episode(agent1, agent2, n_steps=100)
    print(f"\n测试结果(ε=0): Agent1总奖励={test_r1:.1f}, Agent2总奖励={test_r2:.1f}")
    print("最终Q表(Agent1):")
    print(agent1.Q)
    print("最终Q表(Agent2):")
    print(agent2.Q)
运行与验证
- 运行方式:将代码保存为
iql_baseline.py,执行python iql_baseline.py。 - 预期输出特征(因ε-greedy随机性,数值不完全一致但趋势相同):
- 训练初期(前100回合)总奖励波动较大,智能体在合作与背叛间试探。
- 训练后期(400回合后)总奖励趋于稳定,但通常无法稳定收敛到帕累托最优的(3,3)合作策略——这正是IQL作为基线的典型表现:由于智能体独立更新、不考虑对手策略变化,环境非平稳导致Q值震荡。
- 测试阶段(ε=0)时,两个智能体各自选择其Q值最大的动作。若收敛到相互背叛(1,1),则每步总奖励为2.0,100步总奖励约200;若偶尔收敛到合作,则每步总奖励为6.0。
- 判定通过条件:程序无报错运行完成;训练过程中两个智能体的Q表均发生更新(数值非全零);测试阶段输出总奖励数值在合理范围(每步总奖励介于2.0~6.0之间,即100步总奖励在200~600之间)。
关键说明
- 本实现中每个智能体的“状态”仅包含自身上一动作,不包含对手动作或奖励——严格满足IQL“不共享信息”的设定。
- 由于环境非平稳(对手也在学习),IQL通常无法保证收敛。若需复现更稳定的对比结果,可增加训练回合数至2000以上,但预期仍会出现策略震荡。
- 该基线代码可直接作为后续CTDE方法(如QMIX、MADDPG等)的对比参照:在相同环境与奖励设置下,CTDE方法应能更稳定地收敛到合作策略。