1. CEVA-X DSP架构与指令集概览
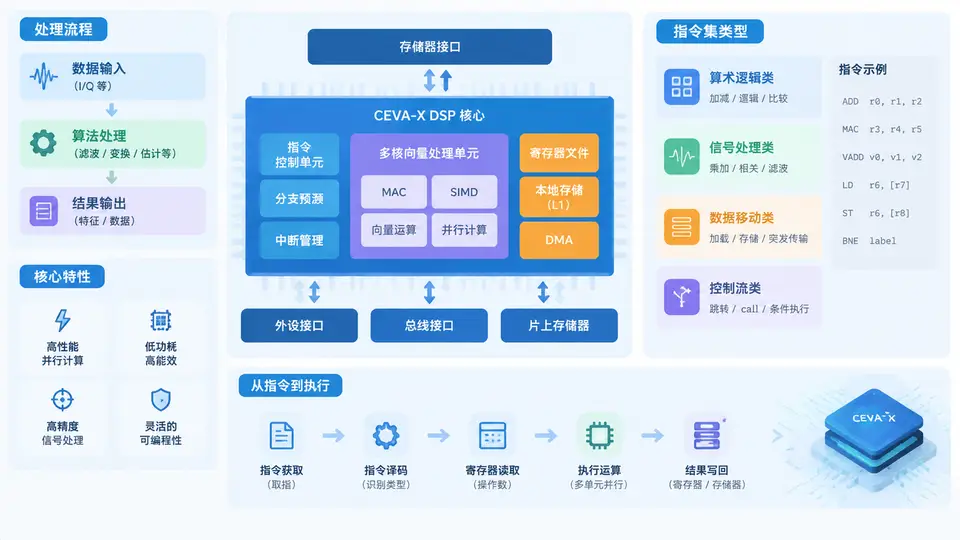
任务目标
本案例面向已有通用处理器(如ARM、x86)开发经验、但首次接触CEVA-X系列DSP的基带算法移植工程师。完成本案例后,你应能:① 识别CEVA-X DSP的哈佛架构、SIMD与VLIW关键特征;② 读懂CEVA-X汇编指令中操作数类型与并行执行语法;③ 将一段简单的C语言基带运算(复数乘法累加)映射为CEVA-X指令序列,并确认其数据通路与指令槽分配方式。
CEVA-X架构核心特征
- 哈佛架构:程序存储器与数据存储器物理分离,支持指令与数据并行取指。
- VLIW(超长指令字):每个时钟周期发射多条指令,由编译器静态调度,无硬件冒险检测。
- SIMD(单指令多数据):支持16位/32位向量操作,一条指令可同时处理多个数据元素。
- 专用基带加速单元:包含MAC(乘累加)单元、比特流处理单元(如Viterbi/Turbo加速器),本案例聚焦MAC数据通路。
指令集语法要点
CEVA-X汇编指令采用“操作码 + 并行执行标志 + 操作数”的格式。以下为与本案例直接相关的三类核心指令:
; 向量乘累加:dst_vec += src1_vec * src2_vec(16位×16位→32位累加)
MAC16 dst:acc, src1:vec, src2:vec

; 双16位SIMD乘法(产生两个独立32位结果)
MUL16 dst1:d, src1:vec, src2:vec, dst2:d, src3:vec, src4:vec

; 并行数据搬移(与运算指令同周期执行)
LD32 r0, mem[addr0] || LD32 r1, mem[addr1]其中||表示两条指令在同一VLIW周期内并行发射。操作数前的:后标注了该操作数在寄存器文件中的类型(acc为40位累加器,vec为128位向量寄存器,d为32位通用寄存器)。
最小可复现实例:复数乘累加
基带算法中最常见的核心运算为复数乘累加:acc += a * b,其中a、b均为复数(16位实部+16位虚部)。以下C代码与CEVA-X汇编实现等价:
// C参考实现(输入输出均为16位复数,实部虚部交错存储)
typedef struct { short re; short im; } complex16;
complex16 a[4], b[4];  // 4个复数
int acc_re = 0, acc_im = 0;
for (int i = 0; i < 4; i++) {
    acc_re += a[i].re * b[i].re - a[i].im * b[i].im;
    acc_im += a[i].re * b[i].im + a[i].im * b[i].re;
}
; CEVA-X汇编实现(4个复数并行计算)
; 假设:a的实部/虚部分别加载到向量寄存器 v0(实部), v1(虚部)
; b的实部/虚部分别加载到向量寄存器 v2(实部), v3(虚部)
; 结果累加到40位累加器 acc0(实部累加), acc1(虚部累加)
; 第一步:并行加载4个复数的实部与虚部(每条LD32加载2个16位数据)
LD32 v0, mem[a_re] || LD32 v2, mem[b_re]
LD32 v1, mem[a_im] || LD32 v3, mem[b_im]
; 第二步:计算实部累加:acc0 += v0*v2 - v1*v3
MAC16 acc0, v0, v2 || MAC16 acc0, v1, v3, neg
; 注:neg标志表示乘积累加时取负号,实现减法
; 第三步:计算虚部累加:acc1 += v0*v3 + v1*v2
MAC16 acc1, v0, v3 || MAC16 acc1, v1, v2
; 第四步:将40位累加结果截断为32位并存储
ST32 mem[acc_re], acc0 || ST32 mem[acc_im], acc1关键映射说明
- 数据宽度匹配:C代码中
int为32位累加,CEVA-X的acc寄存器为40位,可容纳4次16位×16位乘法累加而不溢出(最大中间值:4×2^31=2^33,40位可表示±2^39)。 - SIMD并行度:一条
MAC16指令同时处理4个复数通道(128位向量寄存器拆分为4×32位通道,每个通道内为16位实部×16位实部→32位结果)。 - VLIW双发射:第二步与第三步中的
||使两条MAC指令在同一周期执行,充分利用两个MAC单元。 - neg修饰符:CEVA-X的MAC指令支持可选的取反操作,用于实现复数乘法中的减法项,避免额外指令。
验证方法
在CEVA-X工具链(如CEVA-ToolBox IDE)中完成以下步骤:
- 将上述C代码编译为参考可执行文件,记录输出值
acc_re与acc_im。 - 将汇编代码填入同一工程的汇编源文件,与C代码使用相同输入数据(
a[4]与b[4]的初始值)。 - 在IDE中启用指令集模拟器(Instruction Set Simulator),分别运行C版本与汇编版本。
- 对比两个版本的
acc_re与acc_im最终值。若完全一致,则说明汇编指令的SIMD并行度、MAC累加顺序与C代码逻辑等价。
通过条件:汇编版本与C参考版本输出完全一致,且汇编版本在模拟器中的周期计数明显低于C版本(因C编译器通常无法自动向量化此循环)。
常见问题
- 累加器溢出:若输入数据接近16位满幅(±32767),4次累加后可能超过40位范围。此时需在循环内增加
SAT饱和指令或改用分块累加。 - 内存对齐:向量加载指令
LD32要求源地址按4字节对齐。若复数数组未对齐,需先执行ALIGN操作或使用非对齐加载指令(如LD32U)。 - 并行发射冲突:两条MAC指令若同时访问同一累加器(如第二步中两条MAC均写
acc0),则不能并行。本案例中实部与虚部分别使用acc0与acc1,避免冲突。