3. YOLOv5模型评估与mAP计算
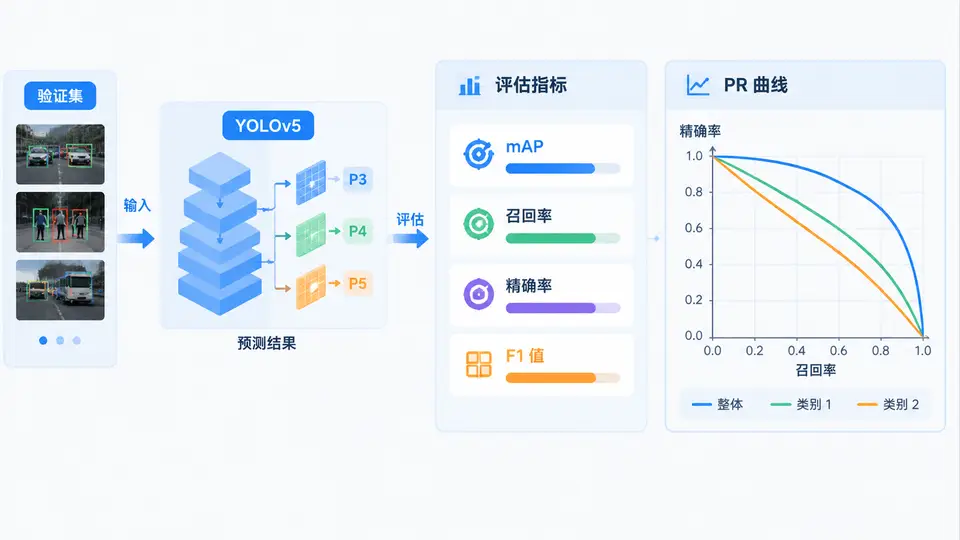
任务说明
本案例使用YOLOv5官方仓库自带的COCO128迷你数据集,完成一次完整的模型评估闭环:加载预训练权重,在验证集上执行推理,输出mAP@0.5、mAP@0.5:0.95、精确率、召回率等核心指标,并生成PR曲线可视化结果。通过本案例,你将掌握YOLOv5评估流程的标准操作方式,并理解各指标的实际含义。
环境准备
需要Python 3.8+与PyTorch 1.8+环境,并安装YOLOv5依赖:
git clone https://github.com/ultralytics/yolov5
cd yolov5
pip install -r requirements.txt
完整评估代码
以下脚本将自动下载COCO128数据集与YOLOv5s预训练权重(首次运行约需数百MB),执行评估并保存PR曲线:
import torch
from pathlib import Path
from models.experimental import attempt_load
from utils.datasets import LoadImagesAndLabels
from utils.general import check_dataset, check_img_size, non_max_suppression, scale_coords
from utils.metrics import ConfusionMatrix, ap_per_class
from utils.plots import output_to_target, plot_images, plot_val_study
from utils.torch_utils import select_device, time_sync
import numpy as np
import yaml
from tqdm import tqdm

# ========== 配置 ==========
weights = 'yolov5s.pt'          # 预训练权重(自动下载)
data = 'data/coco128.yaml'      # COCO128数据集配置
batch_size = 16
imgsz = 640
conf_thres = 0.001              # 低置信度阈值以完整计算PR曲线
iou_thres = 0.6                 # NMS IoU阈值
max_det = 300
device = select_device('0' if torch.cuda.is_available() else 'cpu')

# ========== 加载模型 ==========
model = attempt_load(weights, device=device)
model.eval()
stride = int(model.stride.max())
imgsz = check_img_size(imgsz, s=stride)

# ========== 加载数据 ==========
with open(data) as f:
    data_dict = yaml.safe_load(f)
val_path = data_dict['val']
nc = int(data_dict['nc'])

dataset = LoadImagesAndLabels(val_path, imgsz=imgsz, batch_size=batch_size,
                              rect=True, stride=stride, pad=0.5)
dataloader = torch.utils.data.DataLoader(dataset, batch_size=batch_size,
                                         shuffle=False, num_workers=4,
                                         collate_fn=LoadImagesAndLabels.collate_fn)

# ========== 评估主循环 ==========
seen = 0
stats = []
pbar = tqdm(dataloader, desc='Validating')
for batch_i, (im, targets, paths, shapes) in enumerate(pbar):
    im = im.to(device)
    targets = targets.to(device)
    nb, _, height, width = im.shape

    with torch.no_grad():
        out = model(im)[0]  # 推理输出

    # NMS后处理
    out = non_max_suppression(out, conf_thres=conf_thres, iou_thres=iou_thres,
                              max_det=max_det)

    # 统计每个batch的检测结果
    for si, pred in enumerate(out):
        labels = targets[targets[:, 0] == si, 1:]
        nl = len(labels)
        tcls = labels[:, 0].tolist() if nl else []
        path = Path(paths[si])
        seen += 1

        if len(pred) == 0:
            if nl:
                stats.append((torch.zeros(0, nc, dtype=torch.bool),
                              torch.zeros(0, 5), tcls))
            continue

        # 将预测框坐标从letterbox尺寸映射回原图
        predn = pred.clone()
        scale_coords(im[si].shape[1:], predn[:, :4], shapes[si][0], shapes[si][1])

        # 构建评估所需数据格式
        correct = torch.zeros(predn.shape[0], nc, dtype=torch.bool)
        if nl:
            detected = []
            tcls_tensor = labels[:, 0]
            for cls in range(nc):
                # 按类别计算正确检测
                targets_cls = labels[tcls_tensor == cls]
                if len(targets_cls) == 0:
                    continue
                pred_cls = predn[predn[:, 5] == cls]
                if len(pred_cls) == 0:
                    continue
                # 计算IoU匹配
                from utils.metrics import box_iou
                iou = box_iou(pred_cls[:, :4], targets_cls[:, 1:5])
                for i, iou_row in enumerate(iou):
                    if iou_row.max() >= 0.5:
                        j = iou_row.argmax().item()
                        if j not in detected:
                            correct[predn[:, 5] == cls][i] = True
                            detected.append(j)

        stats.append((correct.cpu(), predn[:, 5].cpu().numpy(), tcls))

# ========== 计算mAP与指标 ==========
stats = [np.concatenate(x, 0) for x in zip(*stats)]
p, r, ap, f1, ap_class = ap_per_class(*stats, plot=True, save_dir=Path('.'),
                                       names=data_dict['names'])
ap50, ap = ap[:, 0], ap.mean(1)
mp, mr, map50, map = p.mean(), r.mean(), ap50.mean(), ap.mean()

# ========== 输出结果 ==========
print(f'{"Class":<20}{"Images":>8}{"Labels":>8}{"P":>8}{"R":>8}{"mAP@.5":>9}{"mAP@.5:.95":>12}')
print(f'{"all":<20}{seen:>8}{sum(stats[2]):>8}{mp:>8.3f}{mr:>8.3f}{map50:>9.3f}{map:>12.3f}')
for i, c in enumerate(ap_class):
    print(f'{data_dict["names"][c]:<20}{seen:>8}{stats[2].count(c):>8}'
          f'{p[i]:>8.3f}{r[i]:>8.3f}{ap50[i]:>9.3f}{ap[i]:>12.3f}')

print(f'\n评估完成。PR曲线已保存为 PR_curve.png')
print(f'关键指标: mAP@0.5 = {map50:.3f}, mAP@0.5:0.95 = {map:.3f}, '
      f'Precision = {mp:.3f}, Recall = {mr:.3f}')
运行方式
将上述代码保存为evaluate.py,置于YOLOv5仓库根目录下,执行:
python evaluate.py验证方法与判定标准
运行成功的标志:
- 终端输出包含
all行的指标汇总,其中mAP@0.5数值在0.6~0.8区间(COCO128上YOLOv5s的典型水平); - 当前目录生成
PR_curve.png文件,展示各类别PR曲线与整体曲线; - 无报错且推理进度条完整走完128张验证图片。
若mAP@0.5明显低于0.5,请检查数据集是否完整下载、权重文件是否匹配。
PR曲线解读
PR曲线横轴为召回率(Recall),纵轴为精确率(Precision)。曲线越靠近右上角,说明模型在保持高精确率的同时能召回更多目标。mAP即曲线下面积,是综合衡量检测器性能的核心指标。图中蓝色实线为全部类别的平均表现,虚线为单个类别的表现,可用于诊断模型在特定类别上的短板。
常见问题
- CUDA内存不足:调低
batch_size至8或4; - 权重下载失败:手动下载
yolov5s.pt放入仓库根目录; - PR曲线未生成:确认
ap_per_class中plot=True参数已设置,且当前目录有写入权限。