3. 工业仪表读数识别
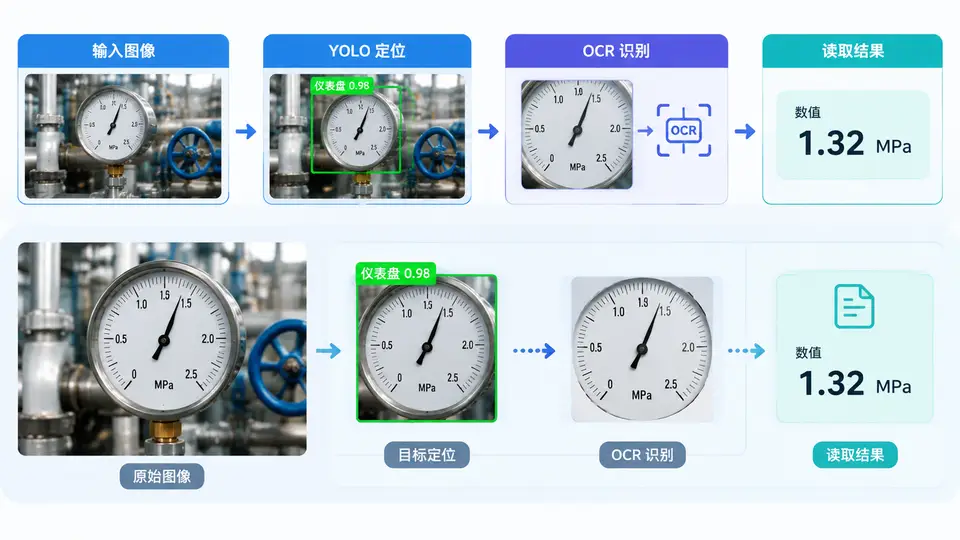
任务说明
工业仪表(如压力表、温度表)普遍存在人工抄表效率低、易出错的问题。本案例使用YOLOv8检测并裁剪表盘区域,再通过OCR技术识别表盘上的数字,实现自动化读数。最终交付一个可直接运行的Python脚本,输入仪表图片,输出识别到的数值文本。
环境依赖
pip install ultralytics opencv-python pytesseract同时需要安装Tesseract OCR引擎(Windows下载安装后,需在代码中指定tesseract_cmd路径;Linux执行sudo apt install tesseract-ocr)。
完整实现
import cv2
import pytesseract
from ultralytics import YOLO

# 如果Windows,取消下一行注释并修改为实际安装路径
# pytesseract.pytesseract.tesseract_cmd = r'C:\Program Files\Tesseract-OCR\tesseract.exe'

def load_model(weights_path):
    """加载YOLO模型,返回检测器"""
    return YOLO(weights_path)

def detect_gauge(model, image):
    """检测仪表盘,返回裁剪后的表盘图像和置信度"""
    results = model(image, conf=0.5)[0]
    boxes = results.boxes
    if len(boxes) == 0:
        return None, 0.0
    # 取置信度最高的检测框
    idx = boxes.conf.argmax()
    x1, y1, x2, y2 = map(int, boxes.xyxy[idx].tolist())
    conf = float(boxes.conf[idx])
    gauge_img = image[y1:y2, x1:x2]
    return gauge_img, conf

def ocr_read(gauge_img):
    """对表盘图像进行OCR识别,返回识别文本"""
    # 预处理:转灰度 + 放大2倍提升小字识别率
    gray = cv2.cvtColor(gauge_img, cv2.COLOR_BGR2GRAY)
    scaled = cv2.resize(gray, None, fx=2.0, fy=2.0, interpolation=cv2.INTER_CUBIC)
    # 自适应阈值增强数字对比度
    thresh = cv2.adaptiveThreshold(scaled, 255, cv2.ADAPTIVE_THRESH_GAUSSIAN_C,
                                   cv2.THRESH_BINARY, 11, 2)
    # 白底黑字模式识别
    config = r'--psm 6 -c tessedit_char_whitelist=0123456789.'
    text = pytesseract.image_to_string(thresh, config=config)
    return text.strip()

def main(image_path, weights_path):
    # 读取图像
    img = cv2.imread(image_path)
    if img is None:
        print(f"无法读取图像: {image_path}")
        return

    # 1. YOLO定位仪表盘
    model = load_model(weights_path)
    gauge, conf = detect_gauge(model, img)
    if gauge is None:
        print("未检测到仪表盘")
        return

    # 2. OCR读取数值
    reading = ocr_read(gauge)
    print(f"检测置信度: {conf:.2f}")
    print(f"识别读数: {reading}")

if __name__ == "__main__":
    # 使用方式: python gauge_reader.py 图片路径 模型权重路径
    import sys
    if len(sys.argv) != 3:
        print("用法: python gauge_reader.py <image_path> <weights_path>")
        sys.exit(1)
    main(sys.argv[1], sys.argv[2])
运行与验证
运行命令:
python gauge_reader.py test_gauge.jpg yolov8n.pt验证路径:
- 准备一张包含清晰表盘的测试图片(手机拍摄即可),表盘数字需肉眼可辨。
- YOLO模型可使用官方预训练权重
yolov8n.pt(通用目标检测),但该权重未针对仪表盘训练,检测效果有限。若需精确检测,应使用标注仪表盘数据微调后的权重,本案例代码已兼容自定义权重文件。 - 运行后观察输出:若打印
检测置信度大于0.5且识别读数包含数字,说明流程闭环成功。 - 判定标准:识别结果与图片中表盘实际数值一致(或包含正确数字),即视为通过。
常见问题
- OCR识别为空:表盘数字过小或反光,可调整
cv2.resize的放大倍数(如改为3.0),或改用--psm 7单行模式。 - 检测不到仪表:确认图片中仪表完整可见,且模型权重支持该类目标。若使用通用权重,可先人工裁剪表盘区域测试OCR部分。
- 识别结果含噪声字符:当前白名单已限制为数字和小数点,若表盘含单位(如MPa),可扩展白名单或后续用正则提取纯数字。