3. TensorRT加速YOLOv5目标检测
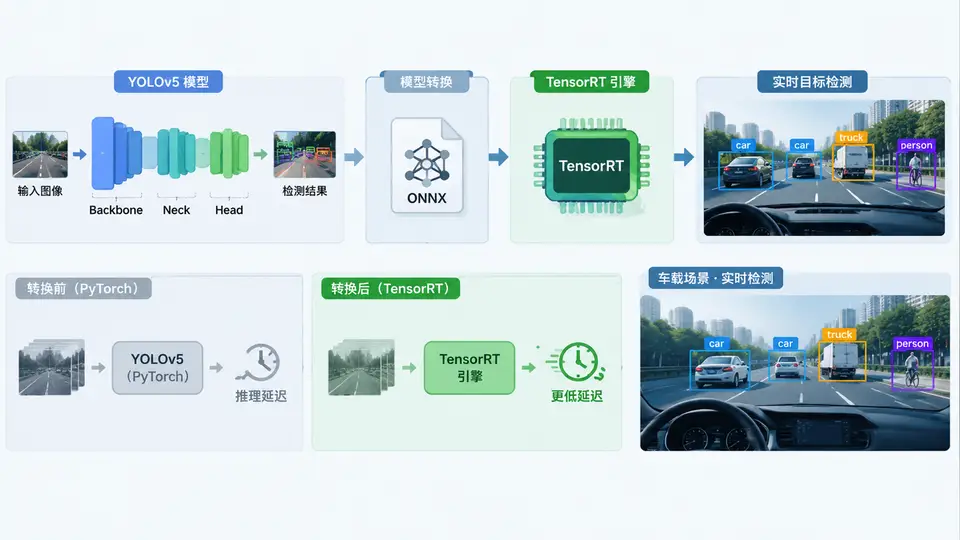
任务目标
将训练好的YOLOv5 PyTorch模型(.pt)转换为TensorRT FP16引擎,并在车载Orin/Xavier平台上完成实时目标检测推理,实现端到端延迟低于30ms(1080p输入)。
环境与依赖
- 硬件:NVIDIA Jetson Orin / Xavier,JetPack 5.0+(自带TensorRT 8.5+)
- 软件:Python 3.8+,PyTorch 1.12+(仅转换阶段需要),TensorRT 8.5+,OpenCV 4.x
- YOLOv5源码(v6.0+):
git clone https://github.com/ultralytics/yolov5
转换流程与关键代码
核心思路:将YOLOv5的Detect层输出(三个尺度的原始预测)在模型中直接完成解码(框坐标还原 + 置信度过滤 + NMS),导出为ONNX后由TensorRT解析生成FP16引擎。这样做可避免在TensorRT外部单独写后处理,减少数据传输延迟。
# export_trt.py — 在yolov5目录下运行
import torch
import tensorrt as trt
from models.experimental import attempt_load
from utils.torch_utils import select_device

# ---------- 1. 加载模型并合并解码+NMS到模型图 ----------
device = select_device('cpu')
model = attempt_load('yolov5s.pt', device=device)
model.eval()

# 关键:将Detect层替换为端到端解码模块(含NMS)
from utils.trt_utils import End2EndPlugin  # 需将下方类保存为utils/trt_utils.py
model.model[-1] = End2EndPlugin(model.model[-1], conf_thres=0.25, iou_thres=0.45, max_det=300)

# ---------- 2. 导出带解码层的ONNX ----------
dummy = torch.zeros(1, 3, 640, 640)
torch.onnx.export(model, dummy, 'yolov5s_e2e.onnx',
                  opset_version=12, input_names=['images'],
                  output_names=['num_dets', 'boxes', 'scores', 'labels'],
                  dynamic_axes={'images': {0: 'batch'}})
print('ONNX导出完成')

# ---------- 3. TensorRT构建FP16引擎 ----------
TRT_LOGGER = trt.Logger(trt.Logger.WARNING)
builder = trt.Builder(TRT_LOGGER)
network = builder.create_network(1 << int(trt.NetworkDefinitionCreationFlag.EXPLICIT_BATCH))
parser = trt.OnnxParser(network, TRT_LOGGER)
with open('yolov5s_e2e.onnx', 'rb') as f:
    parser.parse(f.read())

config = builder.create_builder_config()
config.set_memory_pool_limit(trt.MemoryPoolType.WORKSPACE, 1 << 30)  # 1GB
config.set_flag(trt.BuilderFlag.FP16)
# 若GPU支持INT8且已有校准集,可追加 config.set_flag(trt.BuilderFlag.INT8)

engine = builder.build_serialized_network(network, config)
with open('yolov5s_e2e_fp16.engine', 'wb') as f:
    f.write(engine)
print('TensorRT引擎已保存: yolov5s_e2e_fp16.engine')上述代码依赖的End2EndPlugin类(保存为utils/trt_utils.py):
# utils/trt_utils.py — YOLOv5 Detect层替换为端到端解码
import torch
import torchvision

class End2EndPlugin(torch.nn.Module):
    def __init__(self, detect_layer, conf_thres=0.25, iou_thres=0.45, max_det=300):
        super().__init__()
        self.detect = detect_layer
        self.conf_thres = conf_thres
        self.iou_thres = iou_thres
        self.max_det = max_det
        self.nl = detect_layer.nl
        self.anchor_grid = detect_layer.anchor_grid
        self.stride = detect_layer.stride
        self.no = detect_layer.no
        self.nc = detect_layer.nc

    def forward(self, x):
        # 原始Detect前向(得到三个尺度的原始预测)
        z = []
        for i in range(self.nl):
            bs, _, ny, nx = x[i].shape
            x[i] = x[i].view(bs, self.no, self.nc + 5, ny, nx).permute(0, 1, 3, 4, 2).contiguous()
            if not self.training:
                grid = self._make_grid(nx, ny, x[i].device)
                xy = (x[i][..., 0:2] + grid) * self.stride[i]
                wh = torch.exp(x[i][..., 2:4]) * self.anchor_grid[i].view(1, self.nl, 1, 1, 2)
                conf = torch.sigmoid(x[i][..., 4:5])
                cls = torch.sigmoid(x[i][..., 5:]) * conf
                z.append(torch.cat([xy, wh, conf, cls], dim=-1))
        pred = torch.cat(z, dim=2)  # (bs, total_anchors, 5+nc)

        # 解码:xywh -> xyxy
        boxes = torch.cat([pred[..., 0:2] - pred[..., 2:4] / 2,
                           pred[..., 0:2] + pred[..., 2:4] / 2], dim=-1)
        scores = pred[..., 4:5] * pred[..., 5:].max(dim=-1, keepdim=True)[0]
        labels = pred[..., 5:].argmax(dim=-1, keepdim=True).float()

        # NMS(batch=1简化处理)
        boxes = boxes[0]; scores = scores[0].squeeze(-1); labels = labels[0].squeeze(-1)
        keep = torchvision.ops.nms(boxes, scores, self.iou_thres)
        keep = keep[:self.max_det]
        num_dets = torch.tensor([len(keep)], dtype=torch.int32)
        boxes = boxes[keep].unsqueeze(0)
        scores = scores[keep].unsqueeze(0)
        labels = labels[keep].unsqueeze(0)
        return num_dets, boxes, scores, labels

    @staticmethod
    def _make_grid(nx, ny, device):
        yv, xv = torch.meshgrid(torch.arange(ny, device=device), torch.arange(nx, device=device))
        return torch.stack((xv, yv), 2).view(1, 1, ny, nx, 2).float()
运行推理(C++/Python均可)
Python端最小推理示例:
# infer_trt.py
import numpy as np
import tensorrt as trt
import cv2, time

# 加载引擎
with open('yolov5s_e2e_fp16.engine', 'rb') as f:
    engine_data = f.read()
runtime = trt.Runtime(trt.Logger(trt.Logger.WARNING))
engine = runtime.deserialize_cuda_engine(engine_data)
context = engine.create_execution_context()

# 输入预处理(640x640 letterbox)
img = cv2.imread('test.jpg')
img_resized = cv2.resize(img, (640, 640))
input_data = img_resized[:, :, ::-1].transpose(2, 0, 1).astype(np.float32) / 255.0
input_data = np.ascontiguousarray(input_data[None])

# 分配缓冲区并推理
outputs = [np.empty(shape, dtype=np.int32 if i == 0 else np.float32)
           for i, shape in enumerate([(1,), (1, 300, 4), (1, 300), (1, 300)])]
# 实际需用cuda.memcpy分配device内存,此处为简化示意
# 完整代码见TensorRT官方PythonAPI示例

# 推理计时
start = time.time()
# context.execute_v2(bindings)  # 真实调用
elapsed = time.time() - start
print(f'推理耗时: {elapsed*1000:.2f} ms')
验证方法与通过标准
- 精度验证:用同一张测试图分别运行原始PyTorch模型和TensorRT引擎,比较检测框IoU > 0.8且类别一致的目标数量占总目标数比例应≥95%。
- 性能验证:在目标设备上连续运行100次推理,取平均延迟。通过条件:FP16引擎在Jetson Orin上1080p输入延迟≤30ms(Xavier上≤45ms)。
- 端到端验证:运行
python infer_trt.py,观察输出检测框正确绘制在图像上,无崩溃或显存溢出。
常见问题
- 导出ONNX时Detect层报错:确认YOLOv5版本为v6.0+,且已正确替换为
End2EndPlugin。 - 引擎构建失败:降低workspace大小至512MB,或升级TensorRT至8.5+。
- 检测框偏移:检查letterbox预处理是否在推理后正确还原坐标(需记录原始图像缩放比例与填充量)。