1. 基于PTQ的8位权重量化
任务目标
对预训练PyTorch模型执行8位权重的后训练量化(PTQ),对比量化前后模型精度,并导出量化后的模型文件。本案例聚焦仅权重量化(不量化激活),以最小改动完成INT8模型转换与验证闭环。
环境依赖
- Python 3.8+,PyTorch ≥ 1.13(torch.ao.quantization API)
- torchvision(用于加载预训练模型与数据集)
实现代码
import torch
import torch.nn as nn
import torchvision
import torchvision.transforms as transforms
from torch.ao.quantization import quantize_fx, prepare_qat_fx  # 实际使用PTQ路径
from torch.ao.quantization.quantize_fx import prepare_fx, convert_fx

# ---------- 1. 准备浮点模型(以ResNet18为例) ----------
model = torchvision.models.resnet18(weights=torchvision.models.ResNet18_Weights.IMAGENET1K_V1)
model.eval()

# ---------- 2. 准备校准数据(仅需少量样本用于统计权重范围) ----------
transform = transforms.Compose([
    transforms.Resize(256),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])
])
calib_dataset = torchvision.datasets.CIFAR10(root='./data', train=True, download=True, transform=transform)
calib_loader = torch.utils.data.DataLoader(calib_dataset, batch_size=32, shuffle=True, num_workers=2)

# ---------- 3. 配置量化(仅权重量化,per-tensor对称) ----------
qconfig = torch.ao.quantization.QConfig(
    activation=torch.ao.quantization.PlaceholderObserver.with_args(dtype=torch.float32),  # 激活不量化
    weight=torch.ao.quantization.default_per_channel_weight_observer  # 权重8bit量化
)
model_fp32 = model
model_fp32.eval()

# 使用FX图模式量化
qconfig_dict = {"": qconfig}
model_to_quantize = quantize_fx.prepare_fx(model_fp32, qconfig_dict, example_inputs=torch.randn(1, 3, 224, 224))

# ---------- 4. 校准:前向传播收集权重统计信息 ----------
with torch.no_grad():
    for i, (images, _) in enumerate(calib_loader):
        if i >= 10:  # 仅用10个batch校准
            break
        model_to_quantize(images)

# ---------- 5. 转换为量化模型 ----------
model_quantized = quantize_fx.convert_fx(model_to_quantize)

# ---------- 6. 精度评估(CIFAR-10子集,仅演示流程) ----------
test_dataset = torchvision.datasets.CIFAR10(root='./data', train=False, download=True, transform=transform)
test_loader = torch.utils.data.DataLoader(test_dataset, batch_size=64, shuffle=False)

def evaluate(model, loader, device='cpu'):
    model.to(device)
    model.eval()
    correct = 0
    total = 0
    with torch.no_grad():
        for images, labels in loader:
            images, labels = images.to(device), labels.to(device)
            outputs = model(images)
            _, predicted = torch.max(outputs, 1)
            total += labels.size(0)
            correct += (predicted == labels).sum().item()
    return 100.0 * correct / total

# 注意:ResNet18在CIFAR-10上精度远低于ImageNet,此处仅用于相对比较
fp32_acc = evaluate(model_fp32, test_loader)
int8_acc = evaluate(model_quantized, test_loader)
print(f"FP32精度: {fp32_acc:.2f}%")
print(f"INT8权重量化精度: {int8_acc:.2f}%")
print(f"精度损失: {fp32_acc - int8_acc:.2f}个百分点")

# ---------- 7. 导出量化模型 ----------
torch.save(model_quantized.state_dict(), "resnet18_weight_int8.pth")
print("量化模型已保存至 resnet18_weight_int8.pth")
运行方式
# 安装依赖(如缺失)
pip install torch torchvision

# 运行脚本(首次会自动下载CIFAR-10数据集与ResNet18权重)
python ptq_weight_int8.py
验证方法与判定标准
- 执行成功标志:脚本无异常退出,控制台输出FP32与INT8精度数值及保存路径。
- 量化有效性:INT8模型精度与FP32相比损失通常应小于2个百分点(在CIFAR-10上因模型与数据集不匹配,损失可能略大,但应保持在同一量级)。
- 模型文件检查:生成的
resnet18_weight_int8.pth文件大小约为FP32模型的1/4(约11MB vs 45MB),可用ls -lh确认。 - 加载验证:通过
torch.load加载state_dict并重新构建模型,确认无键名不匹配错误。
关键说明
- 本案例使用FX图模式量化,自动完成算子融合(如Conv+BN+ReLU),无需手动修改模型结构。
- 校准数据仅用于统计权重数值范围,不进行反向传播;10个batch(320张图)已足够获得稳定量化参数。
- 激活保持FP32,因此推理时仍需要浮点计算单元,但权重存储与矩阵乘法可受益于INT8加速。
- 若需部署到特定硬件(如TensorRT、SNPE),需额外导出为对应格式,本案例仅生成PyTorch原生量化模型。
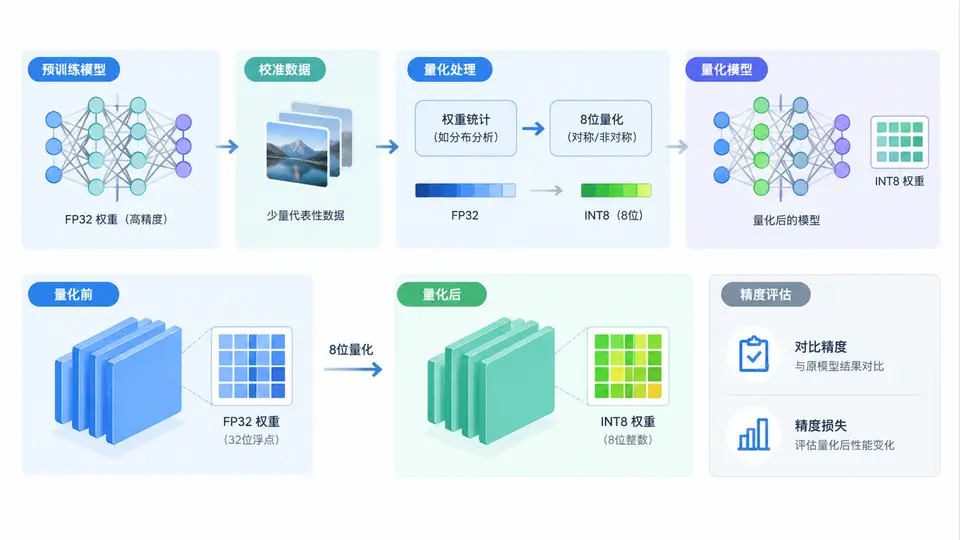
上述SVG展示了PTQ权重量化的完整流程与预期效果。实际精度数值以运行脚本输出为准,本图仅示意量化前后精度应保持在同一水平。