1. 基于权重大小的非结构化剪枝
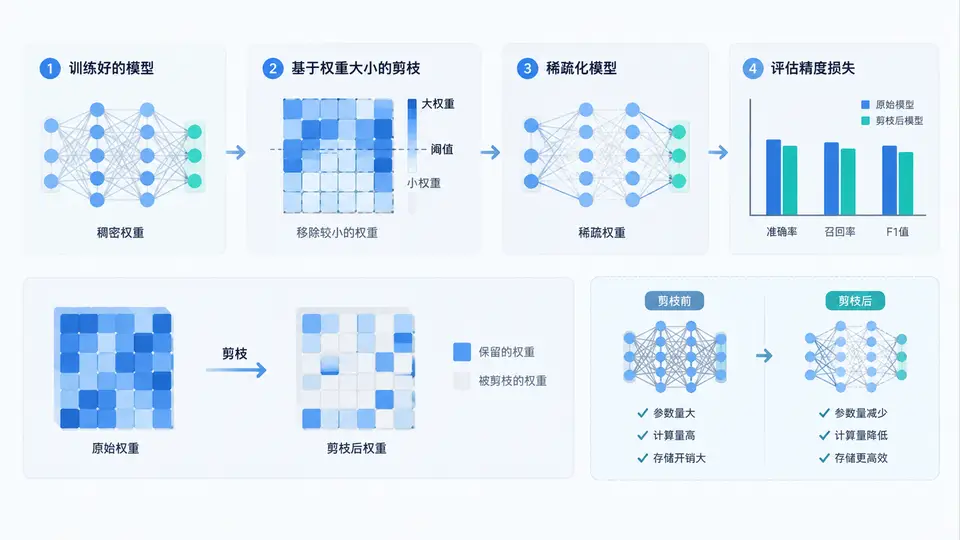
任务说明
对训练好的全连接网络执行基于权重大小的非结构化剪枝:将值最小的指定比例权重置零,使模型稀疏化,并对比剪枝前后在测试集上的精度,验证稀疏化带来的精度损失。
环境依赖
Python 3.8+,PyTorch 1.10+,torchvision,numpy。MNIST数据集首次运行时会自动下载。
关键完整代码
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

# ---------- 1. 定义模型 ----------
class MLP(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(28*28, 128)
        self.fc2 = nn.Linear(128, 64)
        self.fc3 = nn.Linear(64, 10)
        self.relu = nn.ReLU()

    def forward(self, x):
        x = x.view(x.size(0), -1)
        x = self.relu(self.fc1(x))
        x = self.relu(self.fc2(x))
        return self.fc3(x)

# ---------- 2. 训练一个简单模型(仅用于演示剪枝流程) ----------
def train(model, loader, epochs=3):
    optimizer = optim.Adam(model.parameters(), lr=1e-3)
    criterion = nn.CrossEntropyLoss()
    model.train()
    for epoch in range(epochs):
        for data, target in loader:
            optimizer.zero_grad()
            loss = criterion(model(data), target)
            loss.backward()
            optimizer.step()

# ---------- 3. 评估精度 ----------
def evaluate(model, loader):
    model.eval()
    correct = 0
    total = 0
    with torch.no_grad():
        for data, target in loader:
            output = model(data)
            pred = output.argmax(dim=1)
            correct += (pred == target).sum().item()
            total += target.size(0)
    return correct / total

# ---------- 4. 权重大小剪枝 ----------
def magnitude_prune(model, sparsity_ratio):
    """
    将全连接层中值最小的sparsity_ratio比例的权重置零。
    返回掩码字典,便于恢复或进一步微调。
    """
    masks = {}
    for name, param in model.named_parameters():
        if 'weight' in name and param.dim() > 1:  # 只剪全连接权重,不剪bias
            num_weights = param.numel()
            k = int(num_weights * sparsity_ratio)
            if k == 0:
                masks[name] = torch.ones_like(param)
                continue
            # 展平并找到第k小的值作为阈值
            flat = param.abs().view(-1)
            threshold = torch.kthvalue(flat, k).values
            mask = (param.abs() > threshold).float()
            # 处理等于阈值的边界情况,确保恰好剪掉k个
            current_zeros = (mask == 0).sum().item()
            if current_zeros < k:
                # 在等于阈值的元素中随机选择补充置零
                diff = k - current_zeros
                equal_idx = (param.abs() == threshold).nonzero()
                perm = torch.randperm(equal_idx.size(0))[:diff]
                for idx in equal_idx[perm]:
                    mask[tuple(idx)] = 0.0
            param.data.mul_(mask)
            masks[name] = mask
    return masks

# ---------- 5. 主流程 ----------
def main():
    # 数据加载
    transform = transforms.Compose([transforms.ToTensor(), transforms.Normalize((0.1307,), (0.3081,))])
    train_loader = DataLoader(datasets.MNIST('./data', train=True, download=True, transform=transform), batch_size=64, shuffle=True)
    test_loader = DataLoader(datasets.MNIST('./data', train=False, download=True, transform=transform), batch_size=256)

    # 训练基线模型
    model = MLP()
    train(model, train_loader, epochs=3)
    acc_before = evaluate(model, test_loader)
    print(f'剪枝前精度: {acc_before:.4f}')

    # 执行剪枝(剪掉50%的权重)
    sparsity = 0.5
    masks = magnitude_prune(model, sparsity)

    # 统计稀疏度
    total_zeros = 0
    total_params = 0
    for name, param in model.named_parameters():
        if 'weight' in name and param.dim() > 1:
            total_zeros += (param == 0).sum().item()
            total_params += param.numel()
    actual_sparsity = total_zeros / total_params
    print(f'实际稀疏度: {actual_sparsity:.4f}')

    # 剪枝后评估
    acc_after = evaluate(model, test_loader)
    print(f'剪枝后精度: {acc_after:.4f}')
    print(f'精度损失: {acc_before - acc_after:.4f}')

if __name__ == '__main__':
    main()
运行方式
python magnitude_pruning.py验证方法与判定标准
- 程序正常结束并输出三行结果:剪枝前精度、实际稀疏度、剪枝后精度。
- 实际稀疏度应接近设定的0.5(允许±0.01误差),证明剪枝逻辑正确。
- 剪枝后精度与剪枝前相比下降通常在0.05以内(MNIST+3轮训练基线约0.95~0.97),若精度下降过大说明剪枝比例过高或基线训练不足。
- 可通过修改
sparsity变量为0.1、0.3、0.7等观察精度变化趋势,验证剪枝比例与精度损失的正相关性。
关键说明
- 剪枝仅作用于全连接层的weight参数,bias不参与剪枝,这是非结构化剪枝的常见做法。
- 代码使用
torch.kthvalue确定阈值,并处理了边界相等值,确保精确剪掉指定数量的权重。 - 剪枝后模型直接用于评估,未做微调(fine-tune)。实际工程中通常会在剪枝后微调几个epoch以恢复精度,本案例聚焦剪枝本身的效果评估。
- 若需恢复原始模型,可在剪枝前保存
model.state_dict(),或保存返回的masks用于后续加载与微调。