1. 基于L1范数的滤波器剪枝
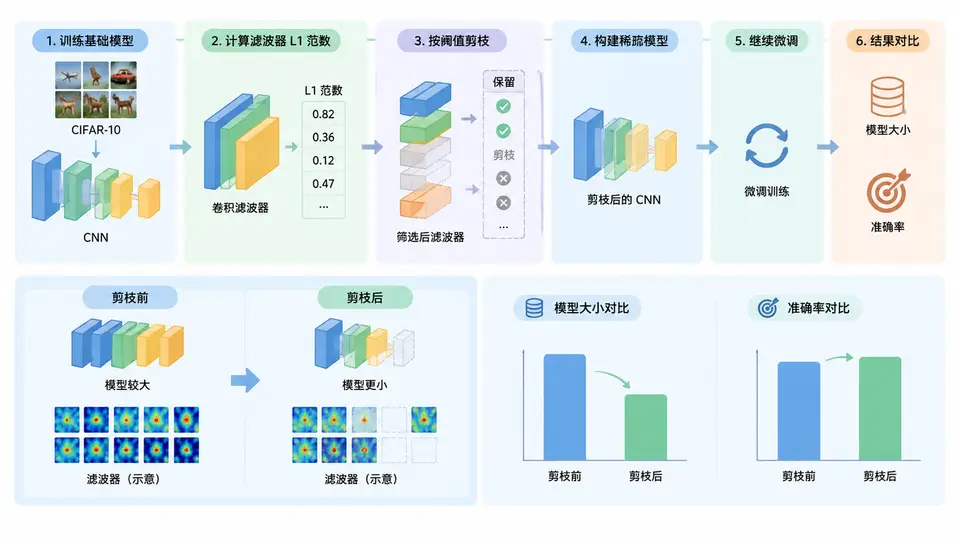
任务目标
在CIFAR-10上训练一个简单CNN,基于滤波器权重的L1范数对卷积层进行剪枝,移除贡献较小的滤波器,然后微调恢复精度,最终对比剪枝前后的模型参数量与准确率。
环境依赖
Python 3.8+,PyTorch 1.10+,torchvision,NumPy。CIFAR-10数据集首次运行时会自动下载(需联网)。
核心实现
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F
from torch.utils.data import DataLoader
from torchvision import datasets, transforms
import copy

# ---------- 1. 定义简单CNN ----------
class SimpleCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv1 = nn.Conv2d(3, 32, 3, padding=1)
        self.conv2 = nn.Conv2d(32, 64, 3, padding=1)
        self.conv3 = nn.Conv2d(64, 128, 3, padding=1)
        self.pool = nn.MaxPool2d(2, 2)
        self.fc1 = nn.Linear(128 * 4 * 4, 256)
        self.fc2 = nn.Linear(256, 10)

    def forward(self, x):
        x = self.pool(F.relu(self.conv1(x)))
        x = self.pool(F.relu(self.conv2(x)))
        x = self.pool(F.relu(self.conv3(x)))
        x = x.view(x.size(0), -1)
        x = F.relu(self.fc1(x))
        return self.fc2(x)

# ---------- 2. 训练/测试工具 ----------
def train(model, loader, optimizer, epochs=1):
    model.train()
    criterion = nn.CrossEntropyLoss()
    for _ in range(epochs):
        for data, target in loader:
            optimizer.zero_grad()
            loss = criterion(model(data), target)
            loss.backward()
            optimizer.step()

def evaluate(model, loader):
    model.eval()
    correct = 0
    with torch.no_grad():
        for data, target in loader:
            pred = model(data).argmax(dim=1)
            correct += (pred == target).sum().item()
    return correct / len(loader.dataset)

# ---------- 3. L1范数滤波器剪枝 ----------
def prune_conv_layer(conv, prune_ratio):
    """按L1范数对单个卷积层剪枝,返回新卷积层(保持输入输出通道数不变,被剪滤波器置零)"""
    l1_norm = conv.weight.abs().sum(dim=(1, 2, 3))  # 每个输出滤波器的L1范数
    num_filters = l1_norm.size(0)
    k = int(num_filters * prune_ratio)
    if k == 0:
        return conv
    _, indices = torch.topk(l1_norm, k, largest=False)  # 范数最小的k个索引
    new_conv = nn.Conv2d(conv.in_channels, conv.out_channels,
                         conv.kernel_size, stride=conv.stride, padding=conv.padding)
    new_conv.weight.data = conv.weight.data.clone()
    new_conv.bias.data = conv.bias.data.clone()
    new_conv.weight.data[indices] = 0  # 将被剪滤波器权重置零
    new_conv.bias.data[indices] = 0
    return new_conv

def prune_model(model, prune_ratio):
    """对模型所有卷积层执行剪枝"""
    model.conv1 = prune_conv_layer(model.conv1, prune_ratio)
    model.conv2 = prune_conv_layer(model.conv2, prune_ratio)
    model.conv3 = prune_conv_layer(model.conv3, prune_ratio)
    return model

# ---------- 4. 主流程 ----------
def main():
    # 数据加载
    transform = transforms.Compose([
        transforms.ToTensor(),
        transforms.Normalize((0.4914, 0.4822, 0.4465), (0.2470, 0.2435, 0.2616))
    ])
    train_set = datasets.CIFAR10('./data', train=True, download=True, transform=transform)
    test_set = datasets.CIFAR10('./data', train=False, download=True, transform=transform)
    train_loader = DataLoader(train_set, batch_size=64, shuffle=True)
    test_loader = DataLoader(test_set, batch_size=256)

    # 训练原始模型
    model = SimpleCNN()
    optimizer = optim.Adam(model.parameters(), lr=0.001)
    print("训练原始模型...")
    train(model, train_loader, optimizer, epochs=3)
    acc_before = evaluate(model, test_loader)
    params_before = sum(p.numel() for p in model.parameters())
    print(f"剪枝前: 参数量={params_before}, 准确率={acc_before:.4f}")

    # 保存原始模型副本用于对比
    original_model = copy.deepcopy(model)

    # 剪枝(每层剪掉50%的滤波器)
    prune_ratio = 0.5
    pruned_model = prune_model(copy.deepcopy(original_model), prune_ratio)
    params_pruned = sum(p.numel() for p in pruned_model.parameters())
    acc_pruned_no_finetune = evaluate(pruned_model, test_loader)
    print(f"剪枝后(未微调): 参数量={params_pruned}, 准确率={acc_pruned_no_finetune:.4f}")

    # 微调
    optimizer = optim.Adam(pruned_model.parameters(), lr=0.0005)
    print("微调剪枝模型...")
    train(pruned_model, train_loader, optimizer, epochs=3)
    acc_after = evaluate(pruned_model, test_loader)
    print(f"剪枝后(微调): 参数量={params_pruned}, 准确率={acc_after:.4f}")

    # 对比结果
    print("\n===== 结果对比 =====")
    print(f"参数量: {params_before} -> {params_pruned} (减少{100*(1-params_pruned/params_before):.1f}%)")
    print(f"准确率: {acc_before:.4f} -> {acc_after:.4f} (微调前{acc_pruned_no_finetune:.4f})")

if __name__ == '__main__':
    main()
运行方式
python l1_pruning.py验证方法与判定标准
- 程序正常结束且无报错,输出三行关键指标:剪枝前准确率、剪枝后未微调准确率、微调后准确率。
- 参数量应显著减少(本例中约减少50%以上,因为每层剪掉一半滤波器)。
- 微调后准确率应明显高于未微调状态,且与剪枝前相比下降幅度在可接受范围内(通常<5%)。
- 若剪枝后准确率骤降(如低于随机猜测10%),说明剪枝比例过高或训练轮数不足,可降低prune_ratio或增加微调epochs。
关键说明
- 本实现采用“置零剪枝”策略:被剪滤波器的权重和偏置置为0,不改变网络结构,因此参数量统计仍包含零值参数。若需真正减少存储,可在此基础上导出稀疏格式或删除对应通道(需处理后续层输入通道匹配)。
- 训练仅3个epoch用于演示流程,实际应用建议训练20-50个epoch以获得更高基线准确率。
- 剪枝比例0.5为示例值,可调整观察不同剪枝率对精度的影响。