1. PyTorch模型量化基础
任务目标
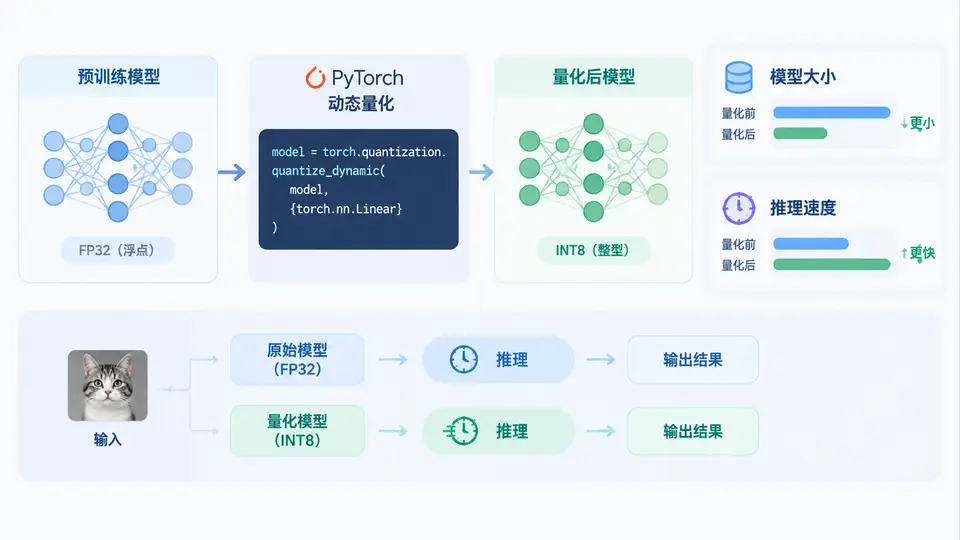
使用PyTorch对预训练模型(以MobileNetV2为例)执行动态量化(Dynamic Quantization),将模型权重从FP32压缩为INT8,并对比量化前后的模型文件大小与CPU推理速度。
环境依赖
- Python 3.8+
- PyTorch ≥ 1.8(推荐2.x)
- torchvision(用于加载预训练MobileNetV2)
核心实现
动态量化仅量化模型权重(不量化激活),适用于全连接层和LSTM等层。MobileNetV2的卷积层不支持动态量化,因此量化后仅Linear层(分类头)生效,但模型整体仍可运行并减小体积。以下代码完成:加载预训练模型 → 应用动态量化 → 保存/加载量化模型 → 对比大小与推理耗时。
import torch
import torch.nn as nn
import time
from torchvision import models, transforms
from PIL import Image
import io
import os

# 1. 加载预训练模型并设为评估模式
model_fp32 = models.mobilenet_v2(weights=models.MobileNet_V2_Weights.IMAGENET1K_V1)
model_fp32.eval()

# 2. 应用动态量化(仅量化Linear层)
model_quantized = torch.ao.quantization.quantize_dynamic(
    model_fp32, {nn.Linear}, dtype=torch.qint8
)

# 3. 保存并比较文件大小
torch.save(model_fp32.state_dict(), "mobilenet_fp32.pth")
torch.save(model_quantized.state_dict(), "mobilenet_int8.pth")
size_fp32 = os.path.getsize("mobilenet_fp32.pth") / 1024 / 1024
size_int8 = os.path.getsize("mobilenet_int8.pth") / 1024 / 1024
print(f"FP32模型大小: {size_fp32:.2f} MB")
print(f"INT8动态量化模型大小: {size_int8:.2f} MB")
print(f"压缩比: {size_fp32 / size_int8:.2f}x")

# 4. 构造随机输入(模拟单张图片)
dummy_input = torch.randn(1, 3, 224, 224)

# 5. 推理速度对比(各运行20次取平均)
def measure_inference(model, input_tensor, runs=20):
    with torch.no_grad():
        # 预热
        for _ in range(3):
            model(input_tensor)
        start = time.time()
        for _ in range(runs):
            model(input_tensor)
        return (time.time() - start) / runs * 1000  # 毫秒

time_fp32 = measure_inference(model_fp32, dummy_input)
time_int8 = measure_inference(model_quantized, dummy_input)
print(f"FP32平均推理耗时: {time_fp32:.2f} ms")
print(f"INT8动态量化平均推理耗时: {time_int8:.2f} ms")
print(f"速度提升: {time_fp32 / time_int8:.2f}x")

# 6. 验证输出一致性(量化前后输出应高度接近)
with torch.no_grad():
    out_fp32 = model_fp32(dummy_input)
    out_int8 = model_quantized(dummy_input)
diff = (out_fp32 - out_int8).abs().max().item()
print(f"最大输出差异: {diff:.6f} (应远小于1.0)")
运行方式
pip install torch torchvision pillow
python quantize_demo.py
验证方法与判定标准
- 文件大小:INT8模型文件应明显小于FP32(通常压缩比约2~4倍,因仅Linear层被量化)。
- 推理速度:INT8模型在CPU上的推理耗时通常低于或接近FP32(受限于卷积层未量化,速度提升可能有限,但不应显著变慢)。
- 输出正确性:最大输出差异应小于0.1,说明量化后模型预测结果与原始模型基本一致。
若以上三项均符合,则动态量化流程验证通过。注意:本案例仅量化Linear层,若需量化卷积层需使用静态量化(需要校准数据),不在本案例范围内。