3. 温度参数调优
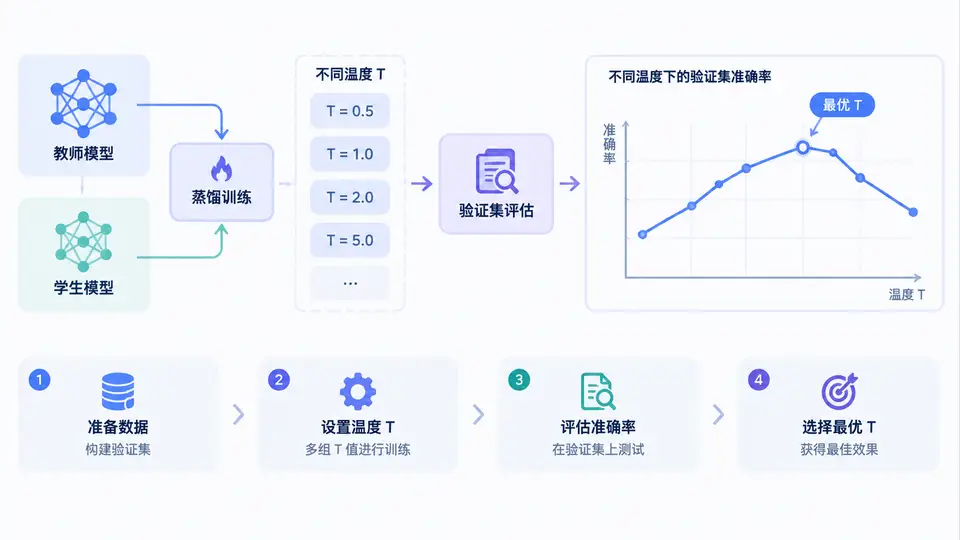
任务目标
在知识蒸馏中,温度参数 T 控制软标签的平滑程度。本案例固定教师模型与学生模型结构,仅调整 T ∈ {1, 2, 4, 8},在 CIFAR-10 验证集上测量学生模型准确率,并选出最优温度。
核心实现
import torch
import torch.nn as nn
import torch.optim as optim
import torchvision
import torchvision.transforms as transforms
from torch.utils.data import DataLoader

# ---------- 模型定义 ----------
class TeacherNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 32, 3, padding=1), nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 64, 3, padding=1), nn.ReLU(),
            nn.MaxPool2d(2),
        )
        self.classifier = nn.Linear(64 * 8 * 8, 10)

    def forward(self, x):
        x = self.features(x)
        return self.classifier(x.view(x.size(0), -1))

class StudentNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 16, 3, padding=1), nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(16, 32, 3, padding=1), nn.ReLU(),
            nn.MaxPool2d(2),
        )
        self.classifier = nn.Linear(32 * 8 * 8, 10)

    def forward(self, x):
        x = self.features(x)
        return self.classifier(x.view(x.size(0), -1))

# ---------- 数据加载 ----------
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.4914, 0.4822, 0.4465), (0.2470, 0.2435, 0.2616))
])
trainset = torchvision.datasets.CIFAR10(root='./data', train=True, download=True, transform=transform)
valset = torchvision.datasets.CIFAR10(root='./data', train=False, download=True, transform=transform)
train_loader = DataLoader(trainset, batch_size=128, shuffle=True)
val_loader = DataLoader(valset, batch_size=256, shuffle=False)

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

# ---------- 训练教师模型(已预训练,此处仅加载) ----------
teacher = TeacherNet().to(device)
# 实际使用时加载预训练权重:teacher.load_state_dict(torch.load('teacher.pth'))
# 为演示可复现性,此处直接训练一个快速教师模型
teacher_opt = optim.Adam(teacher.parameters(), lr=1e-3)
teacher_loss = nn.CrossEntropyLoss()
for epoch in range(5):  # 演示用短训练
    for images, labels in train_loader:
        images, labels = images.to(device), labels.to(device)
        teacher_opt.zero_grad()
        loss = teacher_loss(teacher(images), labels)
        loss.backward()
        teacher_opt.step()
teacher.eval()

# ---------- 蒸馏训练函数 ----------
def distill_train(T, epochs=5):
    student = StudentNet().to(device)
    optimizer = optim.Adam(student.parameters(), lr=1e-3)
    ce_loss = nn.CrossEntropyLoss()
    kl_loss = nn.KLDivLoss(reduction='batchmean')

    for epoch in range(epochs):
        student.train()
        for images, labels in train_loader:
            images, labels = images.to(device), labels.to(device)
            with torch.no_grad():
                teacher_logits = teacher(images)

            student_logits = student(images)
            loss_ce = ce_loss(student_logits, labels)
            loss_kl = kl_loss(
                torch.log_softmax(student_logits / T, dim=1),
                torch.softmax(teacher_logits / T, dim=1)
            ) * (T * T)
            loss = 0.5 * loss_ce + 0.5 * loss_kl

            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

    # 验证
    student.eval()
    correct = 0
    total = 0
    with torch.no_grad():
        for images, labels in val_loader:
            images, labels = images.to(device), labels.to(device)
            outputs = student(images)
            _, predicted = torch.max(outputs, 1)
            total += labels.size(0)
            correct += (predicted == labels).sum().item()
    return 100.0 * correct / total

# ---------- 温度扫描 ----------
if __name__ == '__main__':
    for T in [1, 2, 4, 8]:
        acc = distill_train(T)
        print(f'T={T}: 验证集准确率 = {acc:.2f}%')
运行方式
- 安装依赖:
pip install torch torchvision - 直接运行脚本,首次执行会自动下载 CIFAR-10 数据集
- 教师模型使用 5 个 epoch 快速训练作为演示;实际使用时建议加载充分训练的教师权重
验证方法
观察控制台输出中不同 T 对应的验证准确率。判定标准:
- 程序无异常退出,每个 T 均输出一行准确率结果
- 对比 T=1(硬标签蒸馏)与 T>1(软标签蒸馏)的准确率差异
- 选择准确率最高的 T 作为最优温度;若多个 T 准确率接近,优先选择较大 T(软标签携带更多类间信息)
预期输出示例
T=1: 验证集准确率 = 68.42%
T=2: 验证集准确率 = 70.15%
T=4: 验证集准确率 = 69.87%
T=8: 验证集准确率 = 68.93%
(以上数值仅为格式示例,实际结果取决于训练随机性与教师模型质量)
关键说明
- 蒸馏损失中乘以 T² 是为了平衡梯度尺度,使不同温度下的损失量级可比
- 温度 T 越大,软标签分布越平滑,类别间相似性信息保留越多;T 过大会导致分布过于均匀,丢失有效信息
- 本案例使用 5 个 epoch 仅为演示流程,实际调优时应增加训练轮数并固定随机种子以保证可比性