3. ONNX模型静态量化与动态量化对比
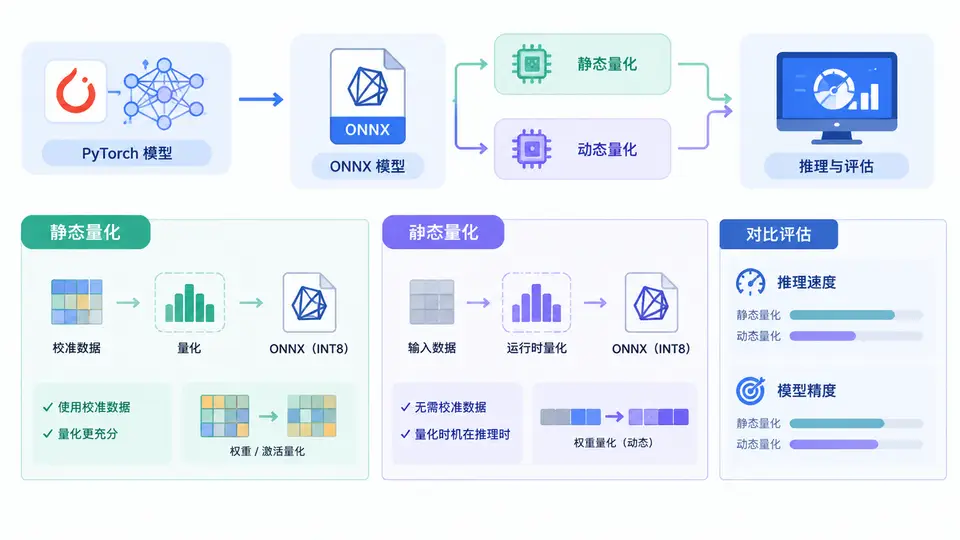
任务目标
本案例使用一个简单的PyTorch卷积神经网络,完成以下闭环:
- 将训练好的模型转换为ONNX格式;
- 对ONNX模型分别执行动态量化和静态量化;
- 对比原始FP32、动态量化、静态量化三种模型在推理速度和精度上的差异。
环境与依赖
需要安装:torch、onnx、onnxruntime、numpy。版本建议:PyTorch ≥ 2.0,ONNX Runtime ≥ 1.16(静态量化需要 onnxruntime.quantization 模块)。
实现代码
以下代码完整实现了从模型定义到三种格式推理对比的全流程。使用随机输入数据模拟校准集和测试集,保证可独立复现。
import torch
import torch.nn as nn
import numpy as np
import onnx
import onnxruntime as ort
from onnxruntime.quantization import quantize_dynamic, quantize_static, QuantType
from onnxruntime.quantization import CalibrationDataReader

# ---------- 1. 定义并导出简单CNN ----------
class SimpleCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv = nn.Conv2d(1, 8, 3, padding=1)
        self.relu = nn.ReLU()
        self.pool = nn.MaxPool2d(2)
        self.fc = nn.Linear(8 * 14 * 14, 10)

    def forward(self, x):
        x = self.pool(self.relu(self.conv(x)))
        x = x.view(x.size(0), -1)
        return self.fc(x)

model = SimpleCNN()
model.eval()
dummy_input = torch.randn(1, 1, 28, 28)
torch.onnx.export(model, dummy_input, "cnn.onnx",
                  input_names=["input"], output_names=["output"],
                  dynamic_axes={"input": {0: "batch"}, "output": {0: "batch"}})
print("ONNX导出完成")

# ---------- 2. 动态量化 ----------
quantize_dynamic("cnn.onnx", "cnn_dynamic.onnx", weight_type=QuantType.QUInt8)
print("动态量化完成")

# ---------- 3. 静态量化(需要校准数据) ----------
class RandomDataReader(CalibrationDataReader):
    def __init__(self, num_samples=100):
        self.data = [{"input": np.random.randn(1, 1, 28, 28).astype(np.float32)}
                     for _ in range(num_samples)]
        self.idx = 0

    def get_next(self):
        if self.idx < len(self.data):
            d = self.data[self.idx]
            self.idx += 1
            return d
        return None

quantize_static("cnn.onnx", "cnn_static.onnx",
                RandomDataReader(100),
                quant_format=QuantType.QOperator,
                per_channel=False)
print("静态量化完成")

# ---------- 4. 推理精度与速度对比 ----------
def run_inference(model_path, input_data):
    sess = ort.InferenceSession(model_path, providers=["CPUExecutionProvider"])
    input_name = sess.get_inputs()[0].name
    # 预热
    for _ in range(5):
        sess.run(None, {input_name: input_data})
    # 计时(100次)
    import time
    start = time.time()
    for _ in range(100):
        outputs = sess.run(None, {input_name: input_data})
    elapsed = (time.time() - start) / 100 * 1000  # ms/次
    return outputs[0], elapsed

# 生成测试数据(固定随机种子保证可复现)
np.random.seed(42)
test_input = np.random.randn(1, 1, 28, 28).astype(np.float32)

# 参考输出(FP32 ONNX)
ref_output, _ = run_inference("cnn.onnx", test_input)

models = {
    "FP32": "cnn.onnx",
    "Dynamic": "cnn_dynamic.onnx",
    "Static": "cnn_static.onnx",
}

print("\n模型对比结果(100次推理平均):")
print(f"{'模型':<10}{'耗时(ms)':<12}{'最大误差':<12}")
for name, path in models.items():
    out, latency = run_inference(path, test_input)
    max_err = np.max(np.abs(out - ref_output))
    print(f"{name:<10}{latency:<12.4f}{max_err:<12.6f}")
运行方式
将上述代码保存为 quant_compare.py,在安装依赖后直接执行:
python quant_compare.py
验证方法与判定标准
程序会依次输出导出、量化完成的提示,最后打印三种模型的对比表格。判定通过的观察点:
- 文件生成:当前目录出现
cnn.onnx、cnn_dynamic.onnx、cnn_static.onnx三个文件; - 精度对比:动态和静态量化模型与FP32输出的最大误差通常在
1e-2量级(具体值随随机数据波动,但不应出现NaN或数量级异常); - 速度对比:动态或静态量化模型的单次推理耗时通常低于或接近FP32模型(受限于本案例的小模型,速度差异可能不明显,这是正常现象;若耗时略高,可增加推理次数或使用更大模型验证)。
常见问题
- 静态量化报错:请确认
onnxruntime版本 ≥ 1.16,且校准数据生成器正确实现了get_next方法; - 动态量化后精度下降过大:可尝试将
weight_type改为QuantType.QInt8对比效果; - 速度对比不明显:本案例模型极小,量化收益主要体现在大模型或带宽受限场景。可替换为更大的CNN验证趋势。