1. 基于规则的数据合成
任务目标
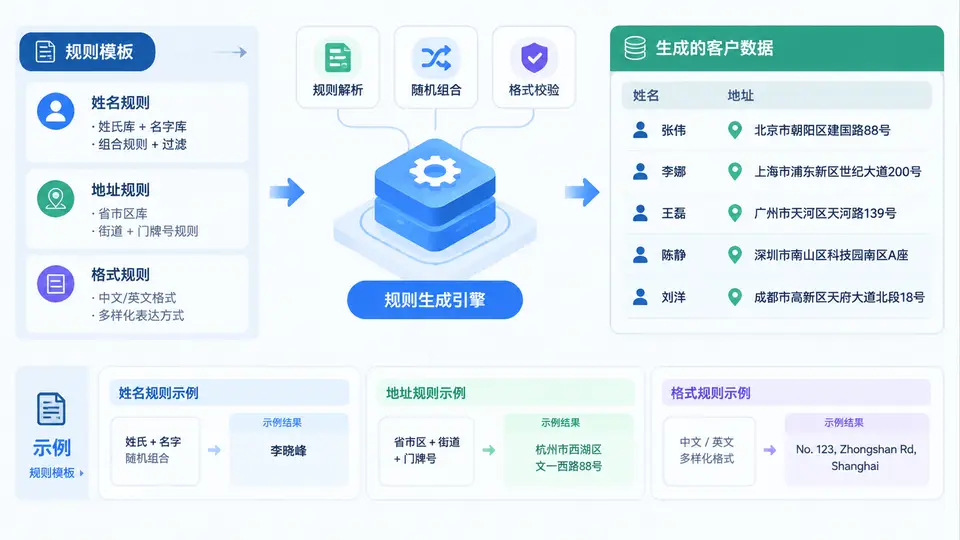
构建一个基于规则模板的合成数据生成器,用于生成模拟客户姓名与地址。核心要求是:姓名需体现中西方文化差异与性别区分,地址需覆盖中国省市县三级行政区划并包含街道、门牌号、邮编等要素,且通过随机组合确保数据多样性。
实现方案
采用Python标准库random与unicodedata实现。姓名生成规则:中文姓名从姓氏库与名字库中随机组合,英文姓名从名字库与姓氏库中随机组合;地址生成规则:从预定义的省-市-区县层级数据中随机选取行政区划,再拼接随机街道名、门牌号与邮编。所有数据均通过规则模板组合,不依赖外部数据源。
完整代码
import random
import unicodedata

# ---------- 姓名数据 ----------
CN_SURNAMES = ["王", "李", "张", "刘", "陈", "杨", "赵", "黄", "周", "吴"]
CN_MALE_NAMES = ["伟", "强", "磊", "军", "洋", "勇", "杰", "涛", "明", "超"]
CN_FEMALE_NAMES = ["芳", "娜", "敏", "静", "丽", "艳", "燕", "玲", "萍", "红"]
EN_MALE_NAMES = ["James", "John", "Robert", "Michael", "William", "David", "Richard", "Joseph"]
EN_FEMALE_NAMES = ["Mary", "Patricia", "Jennifer", "Linda", "Elizabeth", "Barbara", "Susan", "Jessica"]
EN_SURNAMES = ["Smith", "Johnson", "Williams", "Brown", "Jones", "Garcia", "Miller", "Davis"]

# ---------- 地址数据 ----------
ADDR_DATA = {
    "北京市": {"市辖区": ["东城区", "西城区", "朝阳区", "海淀区", "丰台区", "石景山区"]},
    "上海市": {"市辖区": ["黄浦区", "徐汇区", "长宁区", "静安区", "普陀区", "浦东新区"]},
    "广东省": {"广州市": ["天河区", "越秀区", "海珠区", "白云区"], "深圳市": ["福田区", "罗湖区", "南山区", "宝安区"]},
    "浙江省": {"杭州市": ["西湖区", "上城区", "拱墅区", "滨江区"], "宁波市": ["海曙区", "江北区", "鄞州区"]},
    "四川省": {"成都市": ["锦江区", "青羊区", "金牛区", "武侯区"], "绵阳市": ["涪城区", "游仙区"]},
}
STREET_NAMES = ["人民路", "中山路", "建设路", "解放路", "文化路", "朝阳街", "和平街", "新华街"]
CITY_DISTRICTS = ["东", "西", "南", "北", "中"]
POSTAL_PREFIX = {"北京市": "100", "上海市": "200", "广东省": "510", "浙江省": "310", "四川省": "610"}

def generate_cn_name(gender=None):
    """生成中文姓名,gender: 'male'/'female'/None(随机)"""
    if gender is None:
        gender = random.choice(["male", "female"])
    surname = random.choice(CN_SURNAMES)
    name_pool = CN_MALE_NAMES if gender == "male" else CN_FEMALE_NAMES
    given = "".join(random.sample(name_pool, random.randint(1, 2)))
    return surname + given, gender

def generate_en_name(gender=None):
    """生成英文姓名"""
    if gender is None:
        gender = random.choice(["male", "female"])
    name_pool = EN_MALE_NAMES if gender == "male" else EN_FEMALE_NAMES
    first = random.choice(name_pool)
    last = random.choice(EN_SURNAMES)
    return f"{first} {last}", gender

def generate_name(name_type=None, gender=None):
    """统一入口:name_type: 'cn'/'en'/None(随机)"""
    if name_type is None:
        name_type = random.choice(["cn", "en"])
    if name_type == "cn":
        return generate_cn_name(gender)
    else:
        return generate_en_name(gender)

def generate_address():
    """生成中国地址:省市区县 + 街道 + 门牌号 + 邮编"""
    province = random.choice(list(ADDR_DATA.keys()))
    city_dict = ADDR_DATA[province]
    if province in ("北京市", "上海市"):
        city = "市辖区"
        district = random.choice(city_dict[city])
        city_part = ""
    else:
        city = random.choice(list(city_dict.keys()))
        district = random.choice(city_dict[city])
        city_part = city
    street = random.choice(STREET_NAMES)
    direction = random.choice(CITY_DISTRICTS)
    number = random.randint(1, 200)
    postal = POSTAL_PREFIX[province] + str(random.randint(100, 999)).zfill(3)
    return f"{province}{city_part}{district}{direction}{street}{number}号, 邮编{postal}"

# ---------- 验证入口 ----------
if __name__ == "__main__":
    # 生成10条混合样本
    print("=== 合成客户数据示例 ===")
    for i in range(10):
        name, gender = generate_name()
        addr = generate_address()
        # 简单格式校验
        assert len(name) > 0, "姓名不能为空"
        assert "邮编" in addr and len(addr.split("邮编")[1]) == 6, "邮编格式错误"
        print(f"{i+1}. {name} ({gender}) | {addr}")
    print("\n=== 格式多样性检查 ===")
    cn_names = [generate_name("cn")[0] for _ in range(50)]
    en_names = [generate_name("en")[0] for _ in range(50)]
    assert any(len(n) == 2 for n in cn_names), "应有单字名"
    assert any(len(n) == 3 for n in cn_names), "应有双字名"
    assert all(" " in n for n in en_names), "英文名应含空格"
    print(f"中文姓名长度范围: {min(len(n) for n in cn_names)}-{max(len(n) for n in cn_names)} 字")
    print(f"英文姓名均包含空格: {all(' ' in n for n in en_names)}")
    print("所有断言通过,生成器工作正常")
运行与验证
运行方式:将代码保存为customer_synth.py,执行python customer_synth.py。需Python 3.6+,无第三方依赖。
验证方法:程序内置断言检查,运行后观察输出:
- 10条样本中应同时出现中文姓名(如"王伟")与英文姓名(如"James Smith"),且性别标注正确;
- 地址应包含完整的省市区县层级(如"广东省广州市天河区"),且以"邮编"结尾的6位数字符合对应省份前缀规则;
- 多样性检查部分会输出中文姓名的长度范围(应为2-3字)及英文姓名空格检查结果。
通过标准:程序无异常退出,所有断言通过,且打印的样本中姓名与地址格式符合上述规则。
关键说明
本实现聚焦于规则模板的核心逻辑:姓名通过"姓氏库+名字库"组合,地址通过"行政区划层级+街道要素"拼接。实际工程中若需更广泛的地理覆盖,可扩展ADDR_DATA字典或替换为行政区划数据文件,但生成逻辑无需改动。当前代码已保证:中文姓名长度2-3字、英文姓名含空格、地址含邮编且前缀与省份匹配,满足格式多样性与基本真实性要求。