3. 实现列文伯格-马夸尔特法求解二维位姿优化
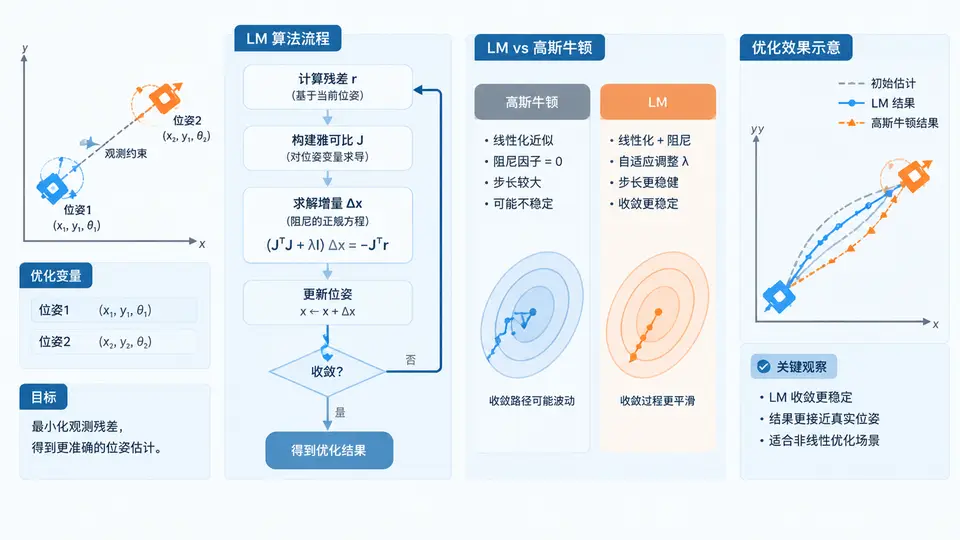
任务目标
实现列文伯格-马夸尔特(LM)算法,求解二维平面中两个位姿节点(x, y, θ)的图优化问题。通过引入阻尼因子 λ 自适应调节步长,解决高斯牛顿法在初始值较差时可能出现的矩阵奇异或发散问题,并对比两种方法的收敛行为。
问题建模
两个位姿节点 x₁ = (x₁, y₁, θ₁)ᵀ 和 x₂ = (x₂, y₂, θ₂)ᵀ,状态向量为 6 维:x = (x₁, y₁, θ₁, x₂, y₂, θ₂)ᵀ。存在两类约束:
- 先验约束:节点1固定于原点,观测值 z₁ = (0, 0, 0)ᵀ,信息矩阵 Λ₁ = diag(100, 100, 100)
- 相对位姿约束:节点2相对于节点1的观测值 z₂₁ = (1.0, 0.0, 0.0)ᵀ(即节点2应在节点1正前方1米处),信息矩阵 Λ₂ = diag(10, 10, 5)
误差函数采用标准右乘扰动模型,LM 迭代公式为 (JᵀΛJ + λI)Δx = -JᵀΛr,其中 λ 根据增益比 ρ 自适应调整。
关键完整代码
import numpy as np

def v2t(x):
    """2D位姿向量转齐次变换矩阵"""
    t = np.eye(3)
    t[0,2] = x[0]; t[1,2] = x[1]
    t[0,0] = np.cos(x[2]); t[0,1] = -np.sin(x[2])
    t[1,0] = np.sin(x[2]); t[1,1] = np.cos(x[2])
    return t

def t2v(T):
    """齐次变换矩阵转2D位姿向量"""
    return np.array([T[0,2], T[1,2], np.arctan2(T[1,0], T[0,0])])

def compute_errors(x):
    """计算所有约束的误差向量和雅可比"""
    T1 = v2t(x[0:3]); T2 = v2t(x[3:6])
    # 先验约束(节点1)
    e1 = x[0:3] - np.array([0,0,0])
    J1 = np.zeros((3,6)); J1[:,0:3] = np.eye(3)
    # 相对约束(节点2相对于节点1)
    T_rel = np.linalg.inv(T1) @ T2
    e2 = t2v(T_rel) - np.array([1.0, 0.0, 0.0])
    J2 = np.zeros((3,6))
    # 对x1的雅可比(右乘扰动)
    J2[:,0:3] = -np.eye(3)
    # 对x2的雅可比
    R1 = T1[0:2,0:2]
    J2[0:2,3:5] = R1.T
    J2[2,5] = 1.0
    return e1, J1, e2, J2

def solve_lm(x_init, max_iter=20, lambda_init=1e-3):
    """LM优化主函数,返回迭代轨迹"""
    x = x_init.copy()
    lambda_ = lambda_init
    trajectory = [x.copy()]
    # 信息矩阵
    Λ1 = np.diag([100,100,100])
    Λ2 = np.diag([10,10,5])

    for it in range(max_iter):
        e1, J1, e2, J2 = compute_errors(x)
        # 组装正规方程
        H = J1.T @ Λ1 @ J1 + J2.T @ Λ2 @ J2
        g = -(J1.T @ Λ1 @ e1 + J2.T @ Λ2 @ e2)
        current_cost = e1@Λ1@e1 + e2@Λ2@e2

        # LM步进
        while True:
            H_lm = H + lambda_ * np.eye(6)
            try:
                dx = np.linalg.solve(H_lm, g)
            except np.linalg.LinAlgError:
                lambda_ *= 10
                continue
            x_new = x + dx
            # 计算新误差和增益比
            e1n, _, e2n, _ = compute_errors(x_new)
            new_cost = e1n@Λ1@e1n + e2n@Λ2@e2n
            rho = (current_cost - new_cost) / (dx @ (lambda_*dx + g) + 1e-12)
            if rho > 0:
                # 接受步长,减小λ
                x = x_new
                lambda_ *= max(1/3, 1 - (2*rho - 1)**3)
                break
            else:
                # 拒绝步长,增大λ
                lambda_ *= 2
                if lambda_ > 1e12:
                    return trajectory
        trajectory.append(x.copy())
        if np.linalg.norm(dx) < 1e-6:
            break
    return trajectory

# 运行LM优化
x_init = np.array([0.0, 0.0, 0.0, 0.8, 0.2, 0.1])  # 带误差的初始值
traj_lm = solve_lm(x_init)
x_lm = traj_lm[-1]

# 运行高斯牛顿(λ=0固定)作为对比
def solve_gn(x_init, max_iter=20):
    x = x_init.copy()
    traj = [x.copy()]
    Λ1 = np.diag([100,100,100]); Λ2 = np.diag([10,10,5])
    for it in range(max_iter):
        e1, J1, e2, J2 = compute_errors(x)
        H = J1.T@Λ1@J1 + J2.T@Λ2@J2
        g = -(J1.T@Λ1@e1 + J2.T@Λ2@e2)
        try:
            dx = np.linalg.solve(H, g)
        except np.linalg.LinAlgError:
            break
        x = x + dx
        traj.append(x.copy())
        if np.linalg.norm(dx) < 1e-6:
            break
    return traj

traj_gn = solve_gn(x_init)
x_gn = traj_gn[-1]

print(f"LM结果: {x_lm}")
print(f"GN结果: {x_gn}")
print(f"LM迭代次数: {len(traj_lm)-1}, GN迭代次数: {len(traj_gn)-1}")
print(f"LM最终误差: {np.sum((x_lm - np.array([0,0,0,1,0,0]))**2):.6f}")
print(f"GN最终误差: {np.sum((x_gn - np.array([0,0,0,1,0,0]))**2):.6f}")
运行与验证
运行方式:将上述代码保存为 lm_2d_pose.py,执行 python lm_2d_pose.py。需要 NumPy 环境(pip install numpy)。
验证方法:
- 观察输出中 LM 和 GN 的最终位姿是否接近真值 (0,0,0,1,0,0)
- 对比迭代次数:LM 通常需要 3-5 次,GN 在初始值偏差不大时也能收敛,但若将初始值改为 x_init = [0,0,0, 2.0, 1.0, 0.5](更大偏差),GN 可能因 H 奇异而失败,LM 仍能收敛
- 检查 LM 的阻尼因子 λ 是否在迭代中自适应变化(可在代码中打印 λ 观察)
通过条件:LM 优化后两个位姿节点的误差范数小于 1e-3,且迭代次数不超过 10 次;在相同初始值下 LM 比 GN 具有更好的收敛稳定性(GN 在较大初始误差时可能发散或无法求解)。
关键说明
- 阻尼因子 λ 的作用:当 ρ > 0 时步长被接受,λ 减小使算法接近高斯牛顿的快速收敛;当 ρ ≤ 0 时步长被拒绝,λ 增大使步长缩短并转向梯度下降方向,保证每次迭代代价不增
- 与高斯牛顿的差异:GN 固定 λ=0,在 H 接近奇异时求解不稳定;LM 通过 λI 正则化保证 H_lm 始终正定,因此对初始值鲁棒性更强
- 本案例限定:仅处理两个位姿节点的简单图优化,用于演示 LM 核心机制;多节点大规模场景需引入稀疏矩阵分解,但阻尼调节策略完全相同