1. 环境准备与llama.cpp源码编译
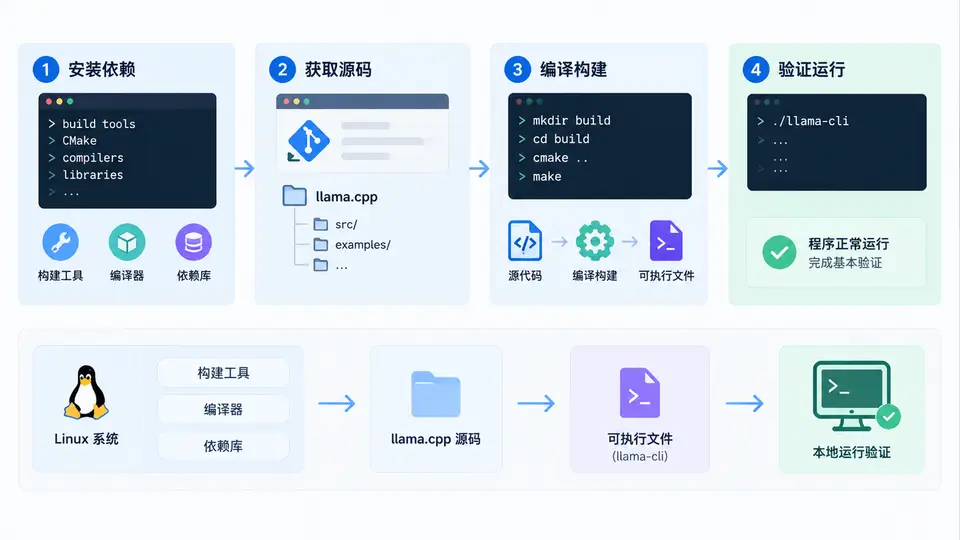
任务目标
在Linux系统上从源码编译llama.cpp,生成llama-cli等可执行文件,并通过运行一个最小模型验证编译产物可用。
环境依赖
- 操作系统:Ubuntu 22.04 / Debian 12(其他Linux发行版需自行适配包管理器命令)
- 工具链:
gcc、g++、make、git、cmake(版本≥3.14) - Python 3(仅用于下载测试模型,非编译必需)
编译步骤
依次执行以下命令完成依赖安装、源码拉取与编译:
# 1. 安装编译依赖
sudo apt update
sudo apt install -y build-essential git cmake

# 2. 拉取llama.cpp源码
git clone https://github.com/ggerganov/llama.cpp.git
cd llama.cpp

# 3. 配置并编译(Release模式,生成优化后的可执行文件)
cmake -B build -DCMAKE_BUILD_TYPE=Release
cmake --build build --config Release -j $(nproc)

# 4. 确认关键可执行文件已生成
ls -l build/bin/llama-cli编译完成后,所有可执行文件位于build/bin/目录下。核心程序为llama-cli(用于文本生成推理),另有llama-server(HTTP服务)、llama-embedding(向量化)等工具。
验证运行
使用一个极小的公开模型ggml-vocab-llama.gguf(仅含词表,约2MB)验证程序能否正常加载模型文件并完成初始化。该模型不包含权重,无法生成文本,但足以验证编译产物与模型加载路径是否正确。
# 下载最小验证模型(来自llama.cpp官方仓库)
wget -P build/bin https://github.com/ggerganov/llama.cpp/raw/master/models/ggml-vocab-llama.gguf

# 运行llama-cli加载该模型,观察是否报错
cd build/bin
./llama-cli -m ggml-vocab-llama.gguf -p "hello" -n 1通过判定标准:程序能正常启动并输出类似llama_model_load: loading model的日志,最终以llama_perf_context_print或正常退出结束,且无error loading model、failed to load等错误信息,即表示编译成功且可执行文件可正常工作。
说明:若需实际生成文本,需下载带权重的量化模型(如
llama-2-7b.Q4_K_M.gguf),但该文件约4GB,不适合作为本案例的快速验证手段。上述最小模型验证已覆盖编译产物完整性的核心检查点。
常见问题
- cmake版本过低:运行
cmake --version检查,若低于3.14,需通过pip install cmake或源码安装升级。 - 内存不足导致编译失败:可在
cmake --build时降低并行度,例如-j 2。 - 缺少OpenBLAS等加速库:本案例默认CPU编译,不依赖额外加速库。如需GPU加速或OpenBLAS,需在cmake配置阶段添加对应选项(如
-DGGML_BLAS=ON),但这不是本案例的必要条件。