3. NPU算子性能基准测试
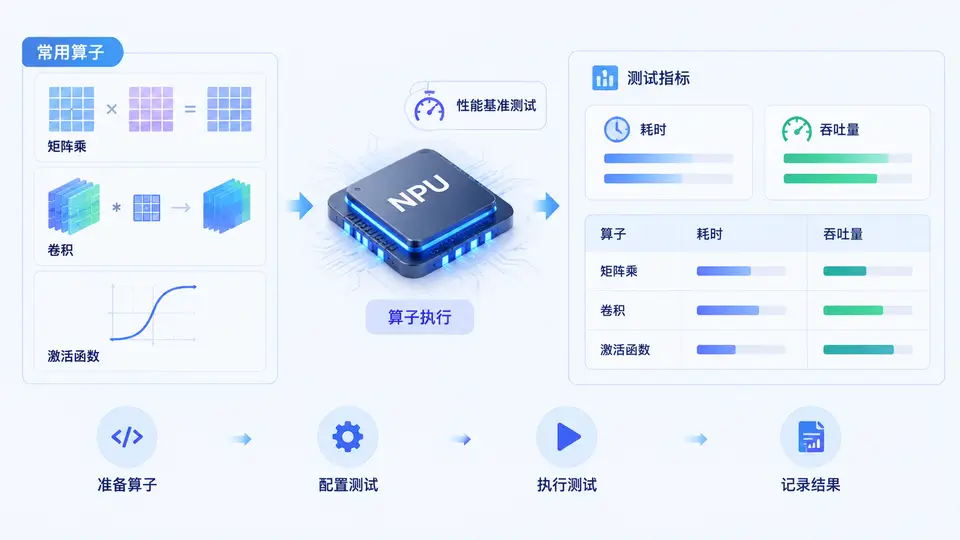
任务目标
在NPU(如昇腾310P/910B)上对矩阵乘(MatMul)、卷积(Conv2D)和激活函数(ReLU)三类常用算子执行性能基准测试,分别记录单次推理耗时与吞吐量(每秒处理样本数),并输出可直接比较的统计结果。
环境与依赖
- 硬件:Atlas 300I Pro / Atlas 800T A2(或其他昇腾NPU)
- CANN Toolkit ≥ 6.0,已配置环境变量
source /usr/local/Ascend/ascend-toolkit/set_env.sh - Python ≥ 3.8,依赖:
torch、torch_npu、numpy
实现思路
使用PyTorch + torch_npu在NPU上创建算子输入张量,通过torch_npu.npu.range计时器(或time.perf_counter)测量算子执行时间。为消除首次调用初始化开销,先执行一次预热(warmup),再循环执行多次取平均耗时。吞吐量按batch_size / 平均耗时计算。矩阵乘与卷积使用固定shape,激活函数以相同shape的ReLU作为代表。
关键完整代码
import torch
import torch_npu
import time
import numpy as np

# 配置:可根据实际NPU显存调整
BATCH = 64
MATMUL_SHAPE = (BATCH, 512, 512)   # 矩阵乘输入
CONV_SHAPE = (BATCH, 64, 32, 32)   # 卷积输入
REPEAT = 50                        # 计时循环次数
WARMUP = 10                        # 预热次数

def npu_benchmark(func, inputs, repeat=REPEAT, warmup=WARMUP):
    """在NPU上执行算子并返回平均耗时(ms)与吞吐量(samples/s)"""
    # 预热
    for _ in range(warmup):
        func(*inputs)
    torch.npu.synchronize()

    # 正式计时
    start = time.perf_counter()
    for _ in range(repeat):
        func(*inputs)
    torch.npu.synchronize()
    elapsed = (time.perf_counter() - start) / repeat * 1000  # ms

    batch = inputs[0].shape[0]
    throughput = batch / (elapsed / 1000)
    return elapsed, throughput

def main():
    device = 'npu:0'
    torch.npu.set_device(device)

    # 1. 矩阵乘 MatMul: (B,512,512) x (B,512,512) -> (B,512,512)
    a = torch.randn(MATMUL_SHAPE, device=device)
    b = torch.randn(MATMUL_SHAPE, device=device)
    matmul_fn = lambda x, y: torch.matmul(x, y)
    mm_time, mm_tput = npu_benchmark(matmul_fn, (a, b))

    # 2. 卷积 Conv2D: (B,64,32,32) -> (B,128,32,32), kernel=3, pad=1
    conv_in = torch.randn(CONV_SHAPE, device=device)
    conv_w = torch.randn(128, 64, 3, 3, device=device)
    conv_b = torch.randn(128, device=device)
    conv_fn = lambda x: torch.nn.functional.conv2d(x, conv_w, conv_b, padding=1)
    conv_time, conv_tput = npu_benchmark(conv_fn, (conv_in,))

    # 3. 激活函数 ReLU: 与卷积同shape
    relu_in = torch.randn(CONV_SHAPE, device=device)
    relu_fn = lambda x: torch.relu(x)
    relu_time, relu_tput = npu_benchmark(relu_fn, (relu_in,))

    # 输出结果
    print(f"{'算子':<10} {'平均耗时(ms)':>14} {'吞吐量(samples/s)':>20}")
    print(f"{'MatMul':<10} {mm_time:>14.3f} {mm_tput:>20.1f}")
    print(f"{'Conv2D':<10} {conv_time:>14.3f} {conv_tput:>20.1f}")
    print(f"{'ReLU':<10} {relu_time:>14.3f} {relu_tput:>20.1f}")

if __name__ == '__main__':
    main()
运行方式
# 在已配置CANN环境的昇腾服务器上执行
python npu_benchmark.py
验证方法与判定标准
- 运行成功标志:程序正常结束并打印三行算子统计表,无报错。
- 结果合理性:MatMul耗时通常高于ReLU,Conv2D介于两者之间(同batch下);吞吐量与耗时成反比关系。
- 可复现性检查:连续运行两次,相同算子的平均耗时波动应小于10%(受NPU频率与负载影响)。
- 正确性抽查:将
device改为'cpu'运行同一脚本,对比NPU与CPU耗时,NPU应显著更快(尤其MatMul与Conv2D),以确认算子确实在NPU上执行。
常见问题
- 显存不足:若报OOM,将
BATCH从64降至32或16。 - 算子执行报错:确认输入shape满足NPU约束(如MatMul维度需为16的倍数),必要时将512改为512(已满足)或使用
torch.npu.format_cast对齐格式。 - 计时不准确:确保
torch.npu.synchronize()在计时前后均调用,否则异步执行会导致耗时偏小。