3. 模型量化与精度对比
任务目标
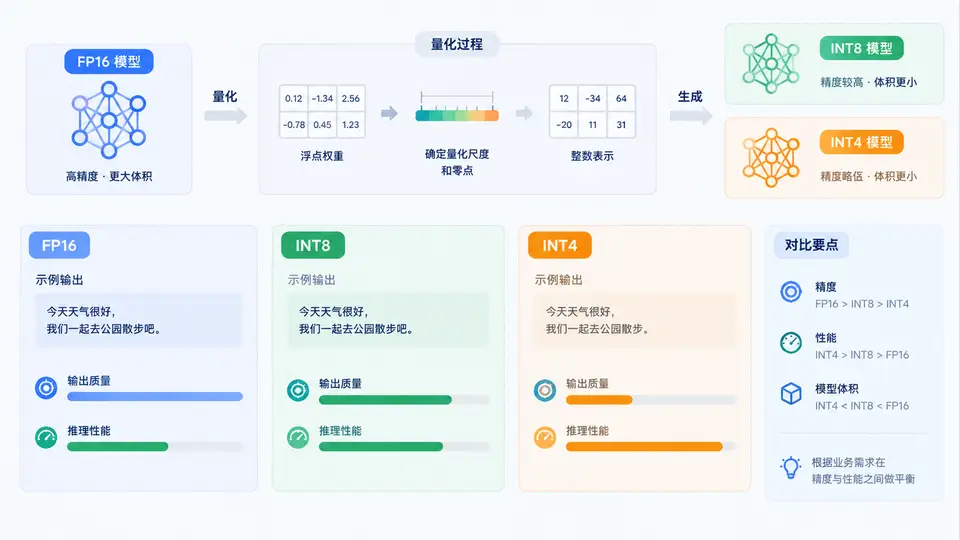
使用llama.cpp将FP16模型分别量化为INT8与INT4,通过对比量化前后模型对相同输入的输出文本及推理速度,建立对量化精度与性能权衡的直观认知。
环境准备
本案例基于llama.cpp官方工具链,需提前完成以下准备:
- 已克隆llama.cpp仓库并完成编译(含
quantize与llama-cli) - 准备一个FP16格式的GGUF模型文件(如
model-f16.gguf),可通过convert_hf_to_gguf.py从HuggingFace模型转换获得
量化执行
使用llama.cpp自带的quantize工具,将FP16模型分别量化为INT8(Q8_0)与INT4(Q4_0)格式:
# INT8量化(Q8_0)
./build/bin/quantize model-f16.gguf model-q8_0.gguf Q8_0

# INT4量化(Q4_0)
./build/bin/quantize model-f16.gguf model-q4_0.gguf Q4_0
量化完成后,三个模型文件(FP16、INT8、INT4)将用于后续对比。
推理对比脚本
以下脚本对同一输入分别运行三个模型,记录输出文本与推理耗时(不含prompt处理时间):
#!/bin/bash
# 对比FP16 / INT8 / INT4的输出与性能
MODELS=("model-f16.gguf" "model-q8_0.gguf" "model-q4_0.gguf")
PROMPT="请用一句话解释什么是量子计算。"
N_THREADS=8

for model in "${MODELS[@]}"; do
    echo "===== $model ====="
    ./build/bin/llama-cli \
        -m "$model" \
        -p "$PROMPT" \
        -n 64 \
        -t $N_THREADS \
        --no-display-prompt \
        -s 42 \
        --temp 0 \
        2>> perf_log.txt
    echo ""
done

# 提取性能指标(llama-cli的stderr输出包含计时信息)
grep "eval time" perf_log.txt关键参数说明:-s 42固定随机种子,--temp 0使用贪心解码,确保输出可复现;--no-display-prompt仅显示生成文本;2>> perf_log.txt将性能日志重定向便于提取。
验证方法与判定标准
运行上述脚本后,按以下步骤验证:
- 输出质量对比:检查三个模型生成的文本是否语义一致、语句通顺。INT8输出应与FP16高度接近;INT4可能出现轻微措辞差异或细节丢失,但核心语义应保持正确。
- 性能对比:查看
perf_log.txt中每个模型的eval time字段(表示生成64个的耗时)。预期趋势为:INT4 < INT8 < FP16,即量化位数越低推理越快。 - 文件大小对比:执行
ls -lh model-*.gguf查看文件大小,确认INT8约为FP16的50%,INT4约为FP16的25%。
通过条件:三个模型均能正常生成与主题相关的连贯文本;INT8与FP16输出语义一致;INT4输出无明显语法错误或主题偏离;且推理耗时满足INT4 ≤ INT8 ≤ FP16的趋势。
常见问题
- 量化后模型无法加载:确认llama.cpp版本支持Q8_0/Q4_0格式(2023年8月后版本均支持),且
quantize工具与llama-cli为同一版本编译。 - 输出差异过大:检查是否固定了随机种子(
-s 42)与温度(--temp 0)。若未固定,采样随机性会导致输出不可比。 - 性能对比不明显:当模型较小或线程数不足时,内存带宽可能不是瓶颈。建议使用7B以上模型,并确保
-t设置为物理核心数。
上图示意了量化级别与推理速度、模型大小的典型关系。实际数值会因模型架构(如LLaMA、Mistral)、硬件平台(CPU型号、内存带宽)而异,但INT4 > INT8 > FP16的速度排序和FP16 > INT8 > INT4的精度排序在多数场景下成立。本案例通过固定输入与随机种子,即可在单一环境中获得可复现的量化对比结论。