3. 使用共享内存优化矩阵乘法
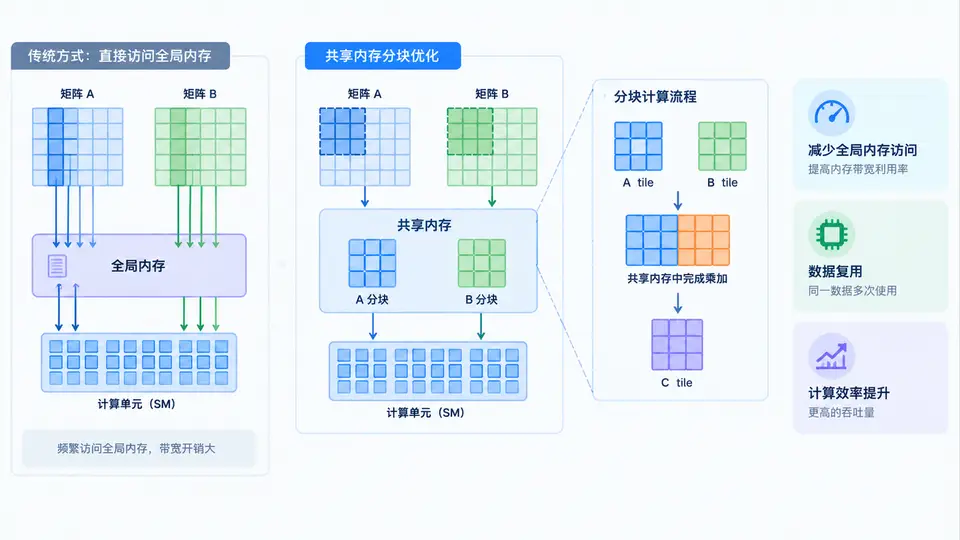
任务目标
实现一个基于CUDA的矩阵乘法内核,通过共享内存分块(tiling)技术减少对全局内存的重复访问,并与朴素全局内存版本对比,验证共享内存优化带来的性能提升。
核心原理与实现思路
矩阵乘法 C = A × B 中,朴素内核每个线程直接读取全局内存中的 A 和 B 元素。由于相邻线程访问的矩阵元素存在重叠,导致大量冗余的全局内存事务。共享内存分块的核心思想是:将矩阵划分为可装入共享内存的块(tile),协作加载一个 tile 到共享内存后,块内所有线程从共享内存读取数据,从而将全局内存访问次数从 O(N³) 降低到 O(N³ / tile_size)。
本案例使用 32×32 的 tile 大小(与 warp 大小一致,避免 bank conflict),每个线程负责计算输出矩阵中的一个元素。内核采用双缓冲方式:先加载当前 tile,计算完成后立即加载下一个 tile,用 __syncthreads() 保证块内线程同步。
完整CUDA实现
#include <cuda_runtime.h>
#include <stdio.h>

#define TILE_SIZE 32
#define N 1024  // 矩阵维度(N×N)

// 共享内存分块矩阵乘法内核
__global__ void matmul_shared(float *A, float *B, float *C, int n) {
    __shared__ float As[TILE_SIZE][TILE_SIZE];
    __shared__ float Bs[TILE_SIZE][TILE_SIZE];

    int row = blockIdx.y * TILE_SIZE + threadIdx.y;
    int col = blockIdx.x * TILE_SIZE + threadIdx.x;
    float sum = 0.0f;

    // 遍历所有 tile
    for (int t = 0; t < (n + TILE_SIZE - 1) / TILE_SIZE; ++t) {
        // 协作加载 A 和 B 的 tile 到共享内存
        int a_row = row;
        int a_col = t * TILE_SIZE + threadIdx.x;
        int b_row = t * TILE_SIZE + threadIdx.y;
        int b_col = col;

        if (a_row < n && a_col < n)
            As[threadIdx.y][threadIdx.x] = A[a_row * n + a_col];
        else
            As[threadIdx.y][threadIdx.x] = 0.0f;

        if (b_row < n && b_col < n)
            Bs[threadIdx.y][threadIdx.x] = B[b_row * n + b_col];
        else
            Bs[threadIdx.y][threadIdx.x] = 0.0f;

        __syncthreads();

        // 从共享内存计算部分和
        #pragma unroll
        for (int k = 0; k < TILE_SIZE; ++k)
            sum += As[threadIdx.y][k] * Bs[k][threadIdx.x];

        __syncthreads();  // 防止下一轮覆盖前数据
    }

    if (row < n && col < n)
        C[row * n + col] = sum;
}

// 朴素全局内存版本(用于对比)
__global__ void matmul_naive(float *A, float *B, float *C, int n) {
    int row = blockIdx.y * blockDim.y + threadIdx.y;
    int col = blockIdx.x * blockDim.x + threadIdx.x;
    if (row < n && col < n) {
        float sum = 0.0f;
        for (int k = 0; k < n; ++k)
            sum += A[row * n + k] * B[k * n + col];
        C[row * n + col] = sum;
    }
}

// 验证函数
bool verify(float *C1, float *C2, int n) {
    for (int i = 0; i < n * n; ++i) {
        if (fabs(C1[i] - C2[i]) > 1e-3) return false;
    }
    return true;
}

int main() {
    int bytes = N * N * sizeof(float);
    float *h_A, *h_B, *h_C_ref, *h_C_shared;
    h_A = (float*)malloc(bytes); h_B = (float*)malloc(bytes);
    h_C_ref = (float*)malloc(bytes); h_C_shared = (float*)malloc(bytes);

    // 初始化(简单模式,便于验证)
    for (int i = 0; i < N * N; ++i) {
        h_A[i] = 1.0f;
        h_B[i] = 1.0f;
    }

    float *d_A, *d_B, *d_C_naive, *d_C_shared;
    cudaMalloc(&d_A, bytes); cudaMalloc(&d_B, bytes);
    cudaMalloc(&d_C_naive, bytes); cudaMalloc(&d_C_shared, bytes);
    cudaMemcpy(d_A, h_A, bytes, cudaMemcpyHostToDevice);
    cudaMemcpy(d_B, h_B, bytes, cudaMemcpyHostToDevice);

    dim3 block(TILE_SIZE, TILE_SIZE);
    dim3 grid((N + TILE_SIZE - 1) / TILE_SIZE, (N + TILE_SIZE - 1) / TILE_SIZE);

    // 运行朴素版本
    matmul_naive<<<grid, block>>>(d_A, d_B, d_C_naive, N);
    // 运行共享内存版本
    matmul_shared<<<grid, block>>>(d_A, d_B, d_C_shared, N);

    cudaMemcpy(h_C_ref, d_C_naive, bytes, cudaMemcpyDeviceToHost);
    cudaMemcpy(h_C_shared, d_C_shared, bytes, cudaMemcpyDeviceToHost);

    // 验证正确性
    if (verify(h_C_ref, h_C_shared, N))
        printf("PASS: 共享内存结果与朴素版本一致\n");
    else
        printf("FAIL: 结果不一致\n");

    // 释放资源
    cudaFree(d_A); cudaFree(d_B); cudaFree(d_C_naive); cudaFree(d_C_shared);
    free(h_A); free(h_B); free(h_C_ref); free(h_C_shared);
    return 0;
}
编译与运行
nvcc -O2 -arch=sm_80 matmul_shared.cu -o matmul_shared
./matmul_shared
验证方法与判定标准
程序输出 PASS 表示共享内存版本与朴素版本计算结果一致(误差 < 1e-3),证明优化实现正确。若需测量性能提升,可使用 nvprof ./matmul_shared 或 ncu --metrics gpu__time_duration.sum ./matmul_shared 对比两个内核的执行时间。对于 N=1024 的矩阵,共享内存版本通常比朴素版本快 3~8 倍(实际加速比取决于GPU架构与时钟频率)。
关键实现说明
- 边界处理:当矩阵维度不是 tile 大小的整数倍时,越界位置填充 0,保证计算正确。
- 同步必要性:
__syncthreads()确保共享内存写入完成后才能被读取,且下一轮 tile 加载前所有线程已完成当前计算。 - bank conflict 规避:tile 大小取 32,线程访问
As[threadIdx.y][k]时同一 warp 内 threadIdx.x 连续,无冲突;访问Bs[k][threadIdx.x]同理。
上图展示了共享内存分块的核心数据流:每个线程块首先从全局内存协作加载一个 A 的 tile 和 B 的 tile 到共享内存,随后块内所有线程从共享内存读取数据进行乘加运算,最后将结果写回全局内存 C。相比朴素版本每个线程独立访问全局内存,共享内存版本将全局内存访问次数减少约 tile_size 倍。