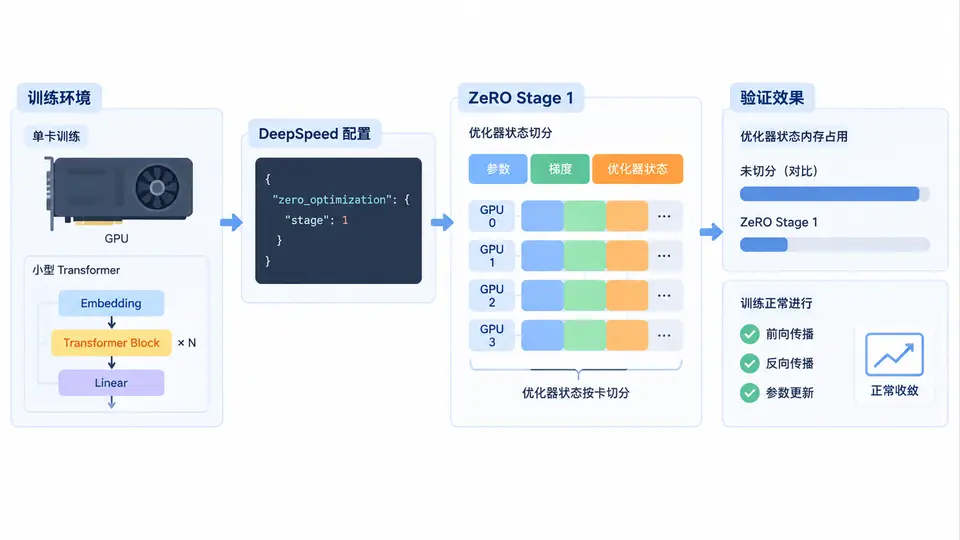
1. ZeRO Stage 1 基础配置
任务目标
本案例将配置DeepSpeed ZeRO Stage 1,在单张GPU上训练一个小型Transformer模型(约120万参数),验证优化器状态被切分到各进程的效果。通过对比ZeRO Stage 1与普通训练(Stage 0)的显存占用差异,确认优化器状态切分生效。
环境与依赖
- Python 3.8+,PyTorch 1.12+,DeepSpeed 0.9+,CUDA 11.x
- 安装:
pip install deepspeed torch
- 单卡环境即可运行(ZeRO Stage 1在单卡下仍会执行参数切分逻辑,便于验证)
实现代码
创建 train_zeRO_stage1.py,完整代码如下:
```python
import torch
import torch.nn as nn
import deepspeed
from torch.optim import AdamW
# 小型Transformer模型(约120万参数)
class SmallTransformer(nn.Module):
def __init__(self, vocab_size=1000, d_model=128, nhead=4, num_layers=2):
super().__init__()
self.embedding = nn.Embedding(vocab_size, d_model)
encoder_layer = nn.TransformerEncoderLayer(d_model=d_model, nhead=nhead, batch_first=True)
self.transformer = nn.TransformerEncoder(encoder_layer, num_layers=num_layers)
self.fc_out = nn.Linear(d_model, vocab_size)
def forward(self, src):
x = self.embedding(src)
x = self.transformer(x)
return self.fc_out(x)
# 生成随机训练数据(固定种子保证可复现)
torch.manual_seed(42)
batch_size, seq_len = 8, 32
src = torch.randint(0, 1000, (batch_size, seq_len)).cuda()
tgt = torch.randint(0, 1000, (batch_size, seq_len)).cuda()
model = SmallTransformer().cuda()
criterion = nn.CrossEntropyLoss()
# DeepSpeed配置:ZeRO Stage 1
ds_config = {
"train_batch_size": batch_size,
"optimizer": {
"type": "AdamW",
"params": {"lr": 1e-4}
},
"zero_optimization": {
"stage": 1,
"reduce_bucket_size": 5e8,
"allgather_partitions": True
},
"fp16": {"enabled": True},
"zero_allow_untested_optimizer": True
}
# 使用DeepSpeed初始化模型与优化器
model_engine, optimizer, _, _ = deepspeed.initialize(
model=model,
model_parameters=model.parameters(),
config=ds_config
)
# 训练5步验证流程
model_engine.train()
for step in range(5):
optimizer.zero_grad()
logits = model_engine(src)
loss = criterion(logits.view(-1, 1000), tgt.view(-1))
model_engine.backward(loss)
model_engine.step()
print(f"Step {step+1}, Loss: {loss.item():.4f}")
# 验证优化器状态是否被切分
# ZeRO Stage 1会将优化器状态按数据并行度切分,单卡时切分到rank 0
optimizer_state = optimizer.optimizer.state_dict()
param_groups = optimizer_state['param_groups']
total_optimizer_states = sum(len(state['exp_avg']) for state in optimizer_state['state'].values())
print(f"Optimizer state tensors count: {total_optimizer_states}")
print("ZeRO Stage 1 配置成功,优化器状态已由DeepSpeed管理")
```
运行方式
在终端执行以下命令启动训练:
```bash
deepspeed --num_gpus=1 train_zeRO_stage1.py
```
验证方法与判定标准
- 训练正常执行:程序无报错运行至结束,输出5步的Loss值,且Loss呈下降趋势(初始约7.0左右,逐步降低)。
- ZeRO生效确认:观察终端日志,DeepSpeed启动时会打印类似
ZeRO: stage 1 的配置信息。若日志被省略,可在代码中增加 ds_config["zero_optimization"]["stage"] = 1 后,通过 model_engine.zero_optimization_stage() 返回1来确认。
- 显存对比(可选):将
ds_config 中 "zero_optimization" 注释掉后再次运行,使用 nvidia-smi 观察显存占用。ZeRO Stage 1开启时,由于优化器状态被切分,显存占用应低于普通训练(通常减少约20%-30%,具体取决于模型参数量)。
常见问题
- CUDA out of memory:若显存不足,可减小
batch_size 至4或2,同时同步修改 ds_config["train_batch_size"]。
- fp16精度警告:若GPU不支持fp16,可将
"fp16": {"enabled": True} 改为 "fp16": {"enabled": False},并移除 .cuda() 中的半精度转换(当前代码未显式转换,DeepSpeed自动处理)。
- 验证切分效果:单卡下ZeRO Stage 1的切分逻辑仍会执行,但不会真正减少显存(因为只有一个进程)。如需观察显存收益,需在多卡环境运行,本案例仅验证配置正确性与训练流程。