3. 下载并加载第一个开源模型
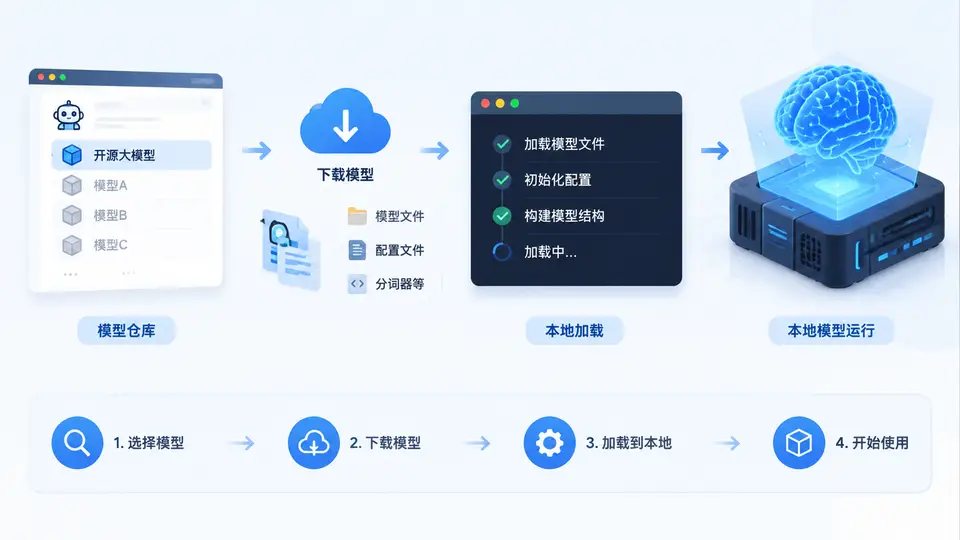
任务目标
本案例将完成从 Hugging Face 下载一个开源大语言模型(以 Qwen/Qwen2.5-0.5B-Instruct 为例),并在本地通过 transformers 库成功加载,最终用一段中文输入验证模型能够生成回复。整个过程不依赖 GPU,仅使用 CPU 即可完成。
环境与依赖
需要 Python 3.9+,并安装以下依赖(建议使用虚拟环境):
pip install transformers huggingface_hub torch --index-url https://download.pytorch.org/whl/cpu如果网络无法直接访问 Hugging Face,可设置镜像环境变量:export HF_ENDPOINT=https://hf-mirror.com(Windows 使用 set HF_ENDPOINT=https://hf-mirror.com)。
完整实现代码
以下代码完成模型下载、加载与推理验证的完整闭环:
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

# 指定模型名称(首次运行会自动下载,约 1GB 参数文件)
model_name = "Qwen/Qwen2.5-0.5B-Instruct"

# 加载分词器与模型(CPU 推理,低精度加载以节省内存)
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.float32,
    device_map="cpu",
    trust_remote_code=True
)

# 构造对话输入(Qwen 的 Chat 模板格式)
messages = [
    {"role": "system", "content": "你是一个乐于助人的中文助手。"},
    {"role": "user", "content": "请用一句话介绍你自己。"}
]
text = tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)

# 编码并生成回复
inputs = tokenizer([text], return_tensors="pt")
outputs = model.generate(
    inputs.input_ids,
    max_new_tokens=128,
    do_sample=False,
    temperature=0.7,
    pad__id=tokenizer.eos__id
)

# 解码并打印结果
response = tokenizer.decode(outputs[0][inputs.input_ids.shape[1]:], skip_special_tokens=True)
print("模型回复:", response)
运行与验证
将上述代码保存为 load_qwen.py,在终端执行:
python load_qwen.py验证通过条件:
- 程序无报错退出,终端输出以“模型回复:”开头的一段中文文本;
- 回复内容与“自我介绍”相关,例如包含“我是”“助手”等语义合理的表述(由于模型较小,回复可能简短,但不应是乱码或与问题无关的重复内容);
- 模型文件已缓存至本地
~/.cache/huggingface/hub目录(Windows 为C:\Users\用户名\.cache\huggingface\hub),说明下载成功。
预期输出示例(实际内容可能因模型版本略有差异):
模型回复: 我是Qwen,一个由阿里云开发的人工智能助手,可以帮助你解答问题、提供建议等。常见问题
- 下载超时:设置
HF_ENDPOINT=https://hf-mirror.com后重试; - 内存不足:若 CPU 内存小于 8GB,可将
torch_dtype改为torch.float16(需 CPU 支持 AVX512,否则会报错),或更换更小的模型如Qwen2.5-0.5B(非 Instruct 版); - transformers 版本过低:执行
pip install -U transformers升级到 4.40+ 版本。