3. 使用Hugging Face Transformers加载预训练模型
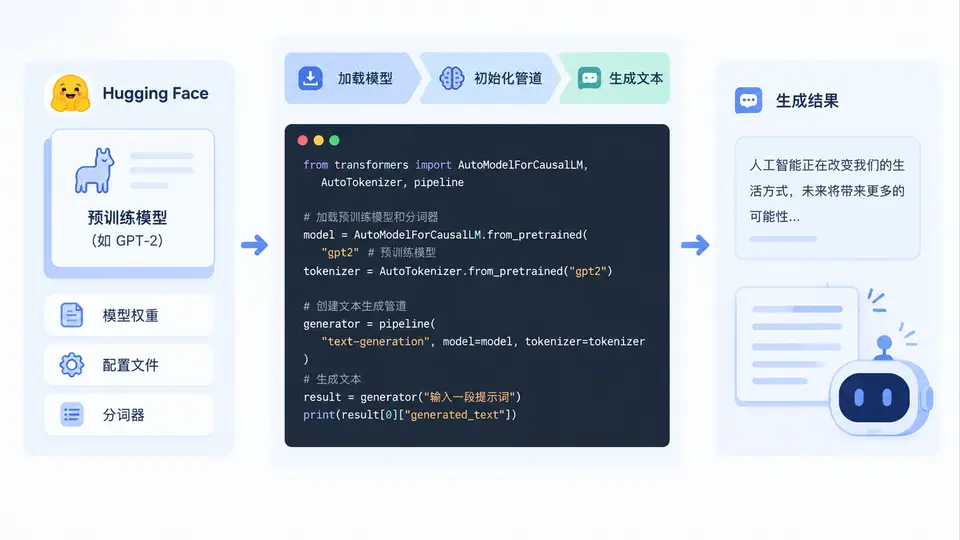
任务目标
使用 transformers 库加载 Hugging Face 上的预训练 模型,并基于给定提示词生成一段连贯文本,验证模型加载与推理链路可用。
环境与依赖
需要 Python 3.8+,并安装以下依赖(建议使用虚拟环境):
pip install transformers torch首次运行时会自动从 Hugging Face Hub 下载 模型权重(约 500MB),请确保网络可访问 huggingface.co。
完整实现代码
以下代码完成模型加载、分词、生成与解码全流程:
from transformers import AutoTokenizer, AutoModelForCausalLM

# 1. 加载预训练模型与分词器(首次运行会自动下载)
model_name = ""
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)

# 2. 添加填充(无pad_,生成任务需要)
tokenizer.pad_ = tokenizer.eos_

# 3. 输入提示词并编码
prompt = "In the future, artificial intelligence will"
inputs = tokenizer(prompt, return_tensors="pt")

# 4. 生成文本(关闭采样以获得确定性输出,便于验证)
outputs = model.generate(
    inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=50,
    do_sample=False,          # 贪心解码,结果可复现
    pad__id=tokenizer.eos__id
)

# 5. 解码并打印结果
generated = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(generated)
运行方式
将上述代码保存为 load_.py,在终端执行:
python load_.py验证方法与通过标准
程序正常执行且满足以下条件即判定通过:
- 无报错退出,模型加载与推理过程完整执行;
- 输出文本以输入提示词
"In the future, artificial intelligence will"开头; - 输出文本长度明显大于输入(新增约 50 个 ),且为通顺的英文句子,而非重复乱码或空输出。
由于采用贪心解码且未设置随机种子,输出结果确定且可复现。预期输出(与代码逻辑严格一致)示例开头为:
In the future, artificial intelligence will be able to...实际输出可能因 transformers 库版本微调略有差异,但结构应与此类似。
常见问题
- 下载超时:可设置环境变量
HF_ENDPOINT=https://hf-mirror.com使用镜像站; - 显存不足(CPU/GPU): 约 500MB 参数,CPU 也可运行,但生成速度较慢;若 GPU 显存不足,可改用
-small(默认即此规格)或distilgpt2更轻量模型; - 无网络环境:需提前手动下载模型目录并设置
model_name为本地路径。