3. 基于LangGraph的反射型Agent
任务目标
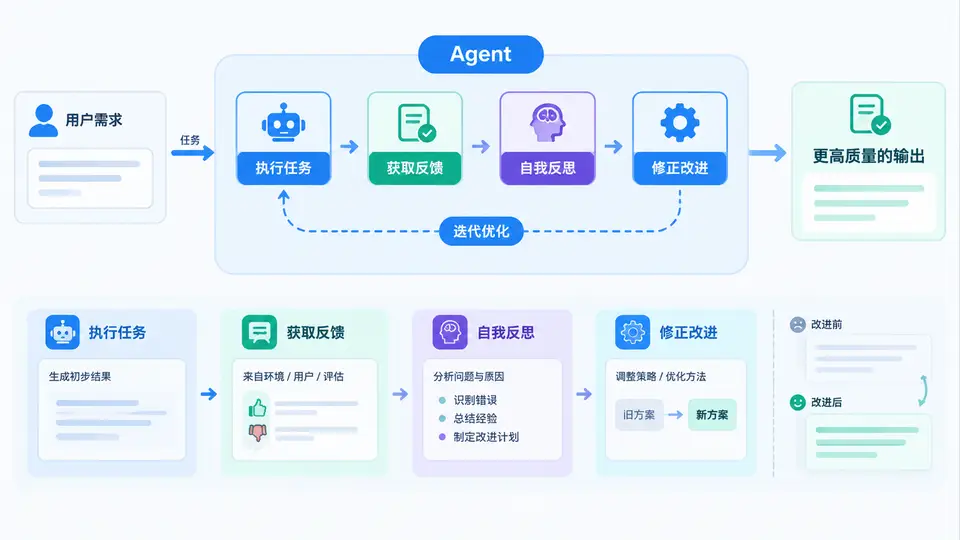
构建一个基于LangGraph的反射型Agent,使其在生成初始回答后,能够根据外部反馈(模拟的批评意见)进行自我反思并修正输出,最终返回改进后的答案。该案例演示了Agent从“生成→反思→修正”的闭环工作流。
环境依赖
需要安装 langgraph 和 langchain-core。本案例使用模拟的LLM调用(返回固定字符串),因此无需真实即可运行。
pip install langgraph langchain-core核心实现
工作流包含三个节点:generate(生成初始回答)、reflect(模拟外部反馈)、revise(根据反馈修正)。状态使用TypedDict定义,包含回答内容与反馈意见。通过条件边判断是否需要进入修正环节。
from typing import TypedDict
from langgraph.graph import StateGraph, END

class AgentState(TypedDict):
    question: str
    answer: str
    feedback: str
    revision_count: int

# 模拟LLM生成初始回答
def generate(state: AgentState) -> dict:
    # 模拟一个不够完善的初始回答
    initial = f"关于“{state['question']}”的初步回答:这是一个复杂问题,需要更多上下文。"
    return {"answer": initial, "revision_count": 0}

# 模拟外部批评/反馈(真实场景可替换为LLM评判或人工输入)
def reflect(state: AgentState) -> dict:
    # 固定模拟反馈:指出回答缺乏具体细节
    feedback = "批评:回答过于笼统,缺少具体步骤或示例。"
    return {"feedback": feedback}

# 根据反馈进行修正
def revise(state: AgentState) -> dict:
    revised = (f"修正后的回答(第{state['revision_count'] + 1}次):"
               f"针对“{state['question']}”,具体步骤如下:\n"
               f"1. 分析问题核心;\n"
               f"2. 给出可操作建议;\n"
               f"3. 提供示例说明。\n"
               f"原反馈:{state['feedback']}")
    return {"answer": revised, "revision_count": state["revision_count"] + 1}

# 判断是否继续修正(最多修正2次)
def should_revise(state: AgentState) -> str:
    if state["revision_count"] < 2:
        return "revise"
    return "end"

# 构建图
graph = StateGraph(AgentState)
graph.add_node("generate", generate)
graph.add_node("reflect", reflect)
graph.add_node("revise", revise)

graph.set_entry_point("generate")
graph.add_edge("generate", "reflect")
graph.add_conditional_edges("reflect", should_revise, {"revise": "revise", "end": END})
graph.add_edge("revise", "reflect")  # 修正后再次进入反馈环节

app = graph.compile()

# 执行
result = app.invoke({"question": "如何提高Python代码性能?", "answer": "", "feedback": "", "revision_count": 0})
print("最终回答:\n", result["answer"])
print("\n修正次数:", result["revision_count"])
运行与验证
直接运行上述脚本。预期输出应包含:
- 最终回答以“修正后的回答(第2次):”开头(因为初始生成后经过2轮修正);
- 回答中包含“1. 分析问题核心”等具体步骤,表明修正逻辑生效;
- 控制台打印“修正次数:2”。
若将should_revise中的阈值改为0,则不会进入修正,最终回答为初始版本——可用于对比验证反射机制确实被触发。
关键说明
- 本案例使用固定字符串模拟LLM输出与反馈,目的是聚焦LangGraph的反射控制流;接入真实LLM时,只需将
generate和reflect节点内部替换为对应模型调用即可。 - 条件边
should_revise展示了如何基于状态动态决定是否继续循环,这是反射型Agent的核心机制。 - 状态中
revision_count用于防止无限循环,实际应用中可根据任务复杂度调整最大修正次数。