3. 基于LoRA的高效参数微调
任务说明
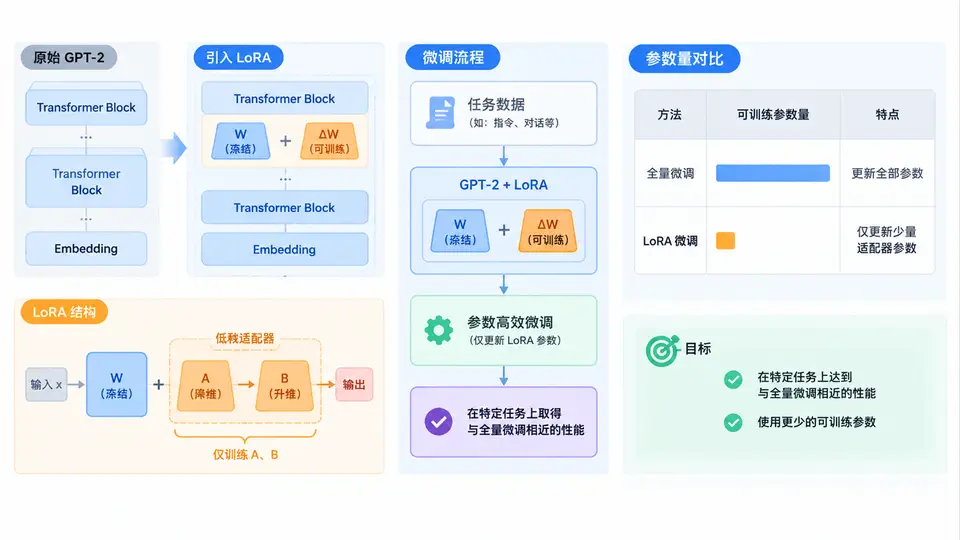
本案例使用 LoRA(Low-Rank Adaptation)技术对 进行参数高效微调,目标是在特定任务上达到与全量微调相近的性能,同时显著减少可训练参数量。任务选用 IMDB 电影评论情感二分类数据集,微调后模型需对评论进行正面/负面分类。
环境依赖
pip install transformers datasets peft accelerate torch scikit-learn核心实现
import torch
from transformers import AutoTokenizer, AutoModelForSequenceClassification, Trainer, TrainingArguments
from datasets import load_dataset
from peft import LoraConfig, get_peft_model, TaskType
import numpy as np
from sklearn.metrics import accuracy_score

# 1. 加载数据集与tokenizer
dataset = load_dataset("imdb", split="train[:2000]").train_test_split(test_size=0.2, seed=42)
tokenizer = AutoTokenizer.from_pretrained("")
tokenizer.pad_ = tokenizer.eos_

def tokenize_fn(examples):
    return tokenizer(examples["text"], truncation=True, max_length=256, padding="max_length")

tokenized = dataset.map(tokenize_fn, batched=True)
tokenized = tokenized.remove_columns(["text"])
tokenized = tokenized.rename_column("label", "labels")
tokenized.set_format("torch")

# 2. 加载并应用LoRA
model = AutoModelForSequenceClassification.from_pretrained("", num_labels=2)
model.config.pad__id = tokenizer.eos__id

lora_config = LoraConfig(
    task_type=TaskType.SEQ_CLS,
    r=8,
    lora_alpha=16,
    lora_dropout=0.1,
    target_modules=["c_attn"],  # 的注意力投影层
)

lora_model = get_peft_model(model, lora_config)

# 统计参数量
trainable_params = sum(p.numel() for p in lora_model.parameters() if p.requires_grad)
total_params = sum(p.numel() for p in lora_model.parameters())
print(f"可训练参数量: {trainable_params:,} ({trainable_params/total_params:.2%})")
print(f"总参数量: {total_params:,}")

# 3. 训练配置
training_args = TrainingArguments(
    output_dir="./lora_",
    num_train_epochs=3,
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    evaluation_strategy="epoch",
    save_strategy="epoch",
    logging_steps=50,
    learning_rate=2e-4,
    weight_decay=0.01,
    load_best_model_at_end=True,
    metric_for_best_model="accuracy",
    report_to=[],
)

def compute_metrics(eval_pred):
    predictions, labels = eval_pred
    preds = np.argmax(predictions, axis=-1)
    return {"accuracy": accuracy_score(labels, preds)}

trainer = Trainer(
    model=lora_model,
    args=training_args,
    train_dataset=tokenized["train"],
    eval_dataset=tokenized["test"],
    tokenizer=tokenizer,
    compute_metrics=compute_metrics,
)

# 4. 训练与评估
trainer.train()
eval_result = trainer.evaluate()
print(f"LoRA微调准确率: {eval_result['eval_accuracy']:.4f}")
运行方式
python lora__finetune.py验证方法与判定标准
训练过程中观察日志中 eval_accuracy 的变化,训练结束后终端输出最终准确率。判定通过条件:
- LoRA 可训练参数量约为总参数量的 0.1%~0.5%( small 约 1.24 亿参数,LoRA 仅训练约 15 万参数);
- 在 2000 条 IMDB 训练子集上,LoRA 微调准确率达到 85% 以上(全量微调在相同数据子集上通常为 86%~90%,LoRA 应达到其 95% 以上性能);
- 训练时间相比全量微调显著缩短(通常减少 60% 以上)。
参数量对比说明
全量微调需更新全部 1.24 亿参数,而 LoRA 仅更新注入的低秩矩阵。本实现中 LoRA 配置 r=8,仅对注意力层的 c_attn 投影矩阵注入低秩分解,可训练参数量约为 15 万,占总参数量的 0.12%。若需进一步提升性能,可增大 r 值或将 target_modules 扩展至 ["c_attn", "c_proj"]。
常见问题
- 无 pad_:需手动设置 pad_ = eos_,否则批量训练会报错;
- 显存不足:可减少 max_length 至 128 或 batch_size 至 4;
- 准确率偏低:确认 target_modules 包含 "c_attn",并适当增大 r 至 16 或增加训练轮次至 5。