1. PPO算法核心组件实现
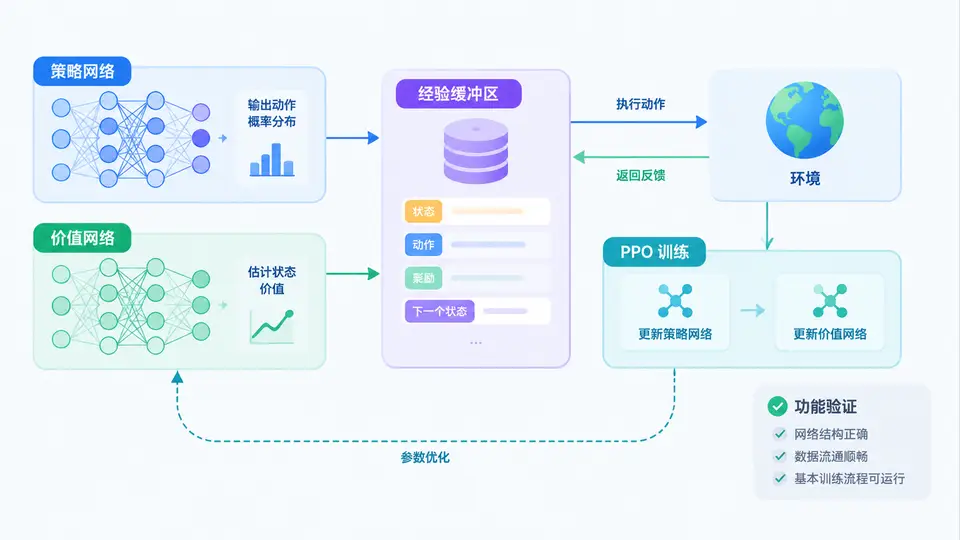
任务目标
实现PPO(Proximal Policy Optimization)算法的三个核心组件:策略网络(Actor)、价值网络(Critic)和经验缓冲区(Replay Buffer),并通过一个简单的随机环境验证组件的前向传播、经验存储与采样的基本功能是否正常。
环境依赖
- Python 3.8+
- PyTorch 1.12+
- NumPy
核心实现
import torch
import torch.nn as nn
import numpy as np
from collections import deque
import random

# ---------- 策略网络(Actor) ----------
class PolicyNetwork(nn.Module):
    """输出动作概率分布参数(连续动作:均值+标准差)"""
    def __init__(self, state_dim, action_dim, hidden_dim=64):
        super().__init__()
        self.fc1 = nn.Linear(state_dim, hidden_dim)
        self.fc2 = nn.Linear(hidden_dim, hidden_dim)
        self.mean_head = nn.Linear(hidden_dim, action_dim)
        self.log_std = nn.Parameter(torch.zeros(action_dim))

    def forward(self, state):
        x = torch.relu(self.fc1(state))
        x = torch.relu(self.fc2(x))
        mean = self.mean_head(x)
        std = torch.exp(self.log_std)
        return mean, std

    def sample_action(self, state):
        """从高斯分布采样动作,返回动作和对数概率"""
        mean, std = self.forward(state)
        dist = torch.distributions.Normal(mean, std)
        action = dist.sample()
        log_prob = dist.log_prob(action).sum(dim=-1)
        return action, log_prob

    def evaluate(self, state, action):
        """计算给定动作的对数概率和熵(用于PPO更新)"""
        mean, std = self.forward(state)
        dist = torch.distributions.Normal(mean, std)
        log_prob = dist.log_prob(action).sum(dim=-1)
        entropy = dist.entropy().sum(dim=-1)
        return log_prob, entropy

# ---------- 价值网络(Critic) ----------
class ValueNetwork(nn.Module):
    """输出状态价值V(s)"""
    def __init__(self, state_dim, hidden_dim=64):
        super().__init__()
        self.fc1 = nn.Linear(state_dim, hidden_dim)
        self.fc2 = nn.Linear(hidden_dim, hidden_dim)
        self.value_head = nn.Linear(hidden_dim, 1)

    def forward(self, state):
        x = torch.relu(self.fc1(state))
        x = torch.relu(self.fc2(x))
        return self.value_head(x)

# ---------- 经验缓冲区 ----------
class RolloutBuffer:
    """存储一条轨迹的经验,用于PPO按epoch更新"""
    def __init__(self, capacity=2048):
        self.capacity = capacity
        self.clear()

    def clear(self):
        self.states = []
        self.actions = []
        self.log_probs = []
        self.rewards = []
        self.dones = []
        self.values = []

    def store(self, state, action, log_prob, reward, done, value):
        """存储单步经验"""
        self.states.append(state)
        self.actions.append(action)
        self.log_probs.append(log_prob)
        self.rewards.append(reward)
        self.dones.append(done)
        self.values.append(value)

    def is_full(self):
        return len(self.states) >= self.capacity

    def get_batch(self):
        """返回整批经验并清空缓冲区"""
        batch = {
            'states': torch.stack(self.states),
            'actions': torch.stack(self.actions),
            'log_probs': torch.stack(self.log_probs),
            'rewards': torch.tensor(self.rewards, dtype=torch.float32),
            'dones': torch.tensor(self.dones, dtype=torch.float32),
            'values': torch.stack(self.values).squeeze(-1)
        }
        self.clear()
        return batch

# ---------- 功能验证 ----------
def verify_components():
    state_dim, action_dim = 4, 2
    actor = PolicyNetwork(state_dim, action_dim)
    critic = ValueNetwork(state_dim)
    buffer = RolloutBuffer(capacity=8)

    # 1. 验证前向传播
    test_state = torch.randn(3, state_dim)
    mean, std = actor(test_state)
    value = critic(test_state)
    assert mean.shape == (3, action_dim), f"均值形状错误: {mean.shape}"
    assert std.shape == (action_dim,), f"标准差形状错误: {std.shape}"
    assert value.shape == (3, 1), f"价值形状错误: {value.shape}"
    print("[PASS] 策略网络和价值网络前向传播正常")

    # 2. 验证采样与评估
    action, log_prob = actor.sample_action(test_state)
    assert action.shape == (3, action_dim)
    assert log_prob.shape == (3,)
    eval_log_prob, entropy = actor.evaluate(test_state, action)
    assert torch.allclose(log_prob, eval_log_prob, atol=1e-5), "采样与评估对数概率不一致"
    print("[PASS] 动作采样与对数概率计算一致")

    # 3. 验证经验缓冲区
    for _ in range(8):
        s = torch.randn(state_dim)
        a, lp = actor.sample_action(s.unsqueeze(0))
        v = critic(s.unsqueeze(0))
        buffer.store(s, a.squeeze(0), lp.squeeze(0), 1.0, False, v.squeeze(0))

    assert buffer.is_full(), "缓冲区应已满"
    batch = buffer.get_batch()
    assert batch['states'].shape == (8, state_dim)
    assert batch['actions'].shape == (8, action_dim)
    assert batch['rewards'].shape == (8,)
    assert len(buffer.states) == 0, "取批后缓冲区应清空"
    print("[PASS] 经验缓冲区存储与取批正常")

    # 4. 验证PPO更新所需数据完整性
    assert 'log_probs' in batch and 'values' in batch
    print("[PASS] 所有PPO更新所需数据字段完整")
    print("\n全部验证通过:PPO核心组件功能正常")

if __name__ == "__main__":
    verify_components()
运行方式
python ppo_components.py验证方法与判定标准
- 前向传播验证:策略网络输出动作均值形状为
(batch_size, action_dim),标准差形状为(action_dim,);价值网络输出形状为(batch_size, 1)。若形状不匹配,程序会抛出断言错误。 - 采样一致性验证:通过
sample_action采样得到的动作,再用evaluate计算对数概率,应与采样时的对数概率一致(误差 < 1e-5)。这确保PPO更新时能正确计算新旧策略的比率。 - 缓冲区功能验证:存入8条经验后缓冲区应报告已满;调用
get_batch()后返回包含states、actions、log_probs、rewards、dones、values六个字段的字典,且缓冲区被清空。 - 通过条件:程序运行后输出
[PASS]标记的四行信息,最后一行显示全部验证通过:PPO核心组件功能正常,即表示所有组件实现正确。
关键说明
- 本实现针对连续动作空间设计,策略网络输出高斯分布的均值和标准差;若处理离散动作,需将输出层改为
logits并使用分类分布。 - 经验缓冲区采用整批更新方式(而非随机小批量采样),这是PPO的标准做法——收集一条完整轨迹后,用同一批数据做多轮epoch更新。
- 价值网络输出
V(s),用于计算优势函数(GAE),本案例未包含优势计算和策略更新循环,这些属于PPO训练主循环的内容,将在后续案例中实现。