1. LoRA基础实现
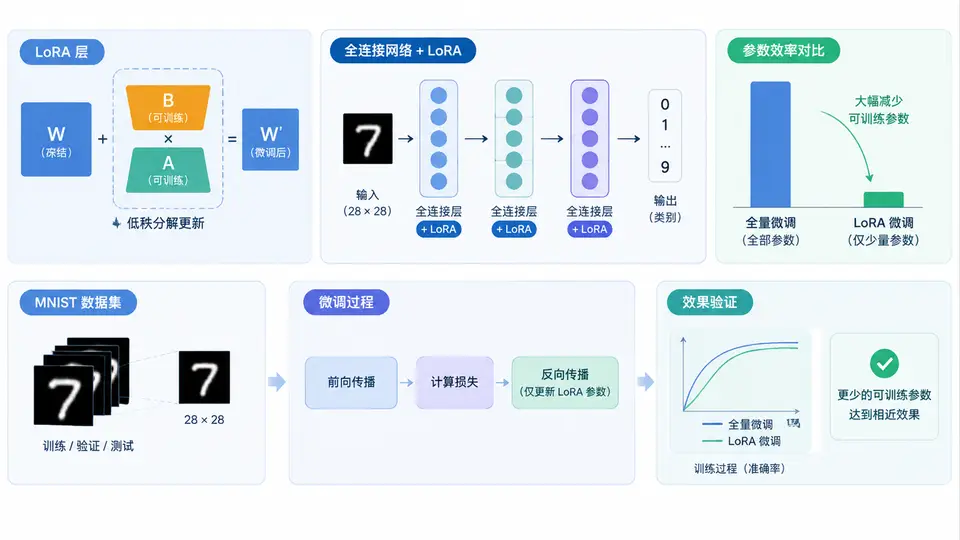
任务目标
实现一个轻量级LoRA层,将其注入到一个两层的全连接网络中,在MNIST数据集上完成手写数字分类微调,并对比可训练参数量与全量微调的差异,验证LoRA的参数效率。
核心实现
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

# ---------- LoRA层 ----------
class LoRALayer(nn.Module):
    def __init__(self, in_features, out_features, rank=4, alpha=1.0):
        super().__init__()
        self.rank = rank
        self.alpha = alpha
        # 冻结原始权重
        self.weight = nn.Parameter(torch.randn(out_features, in_features) * 0.02, requires_grad=False)
        self.bias = nn.Parameter(torch.zeros(out_features), requires_grad=False)
        # LoRA低秩分解
        self.lora_A = nn.Parameter(torch.randn(rank, in_features) * 0.01)
        self.lora_B = nn.Parameter(torch.zeros(out_features, rank))

    def forward(self, x):
        # 原始线性变换 + LoRA增量
        base_out = nn.functional.linear(x, self.weight, self.bias)
        lora_update = (self.alpha / self.rank) * (x @ self.lora_A.t() @ self.lora_B.t())
        return base_out + lora_update

# ---------- 注入LoRA的全连接网络 ----------
class LoRANet(nn.Module):
    def __init__(self, rank=4):
        super().__init__()
        self.fc1 = LoRALayer(784, 256, rank=rank)
        self.fc2 = LoRALayer(256, 10, rank=rank)
        self.relu = nn.ReLU()

    def forward(self, x):
        x = x.view(x.size(0), -1)
        x = self.relu(self.fc1(x))
        return self.fc2(x)

# ---------- 数据加载 ----------
transform = transforms.Compose([transforms.ToTensor(), transforms.Normalize((0.1307,), (0.3081,))])
train_loader = DataLoader(datasets.MNIST('./data', train=True, download=True, transform=transform), batch_size=64, shuffle=True)
test_loader = DataLoader(datasets.MNIST('./data', train=False, download=True, transform=transform), batch_size=256)

# ---------- 训练与验证 ----------
def train(model, epochs=3):
    optimizer = optim.Adam(filter(lambda p: p.requires_grad, model.parameters()), lr=1e-3)
    criterion = nn.CrossEntropyLoss()
    model.train()
    for epoch in range(epochs):
        total_loss = 0
        for images, labels in train_loader:
            optimizer.zero_grad()
            outputs = model(images)
            loss = criterion(outputs, labels)
            loss.backward()
            optimizer.step()
            total_loss += loss.item()
        print(f'Epoch {epoch+1}, Loss: {total_loss/len(train_loader):.4f}')

def evaluate(model):
    model.eval()
    correct = 0
    total = 0
    with torch.no_grad():
        for images, labels in test_loader:
            outputs = model(images)
            _, predicted = torch.max(outputs, 1)
            total += labels.size(0)
            correct += (predicted == labels).sum().item()
    print(f'Test Accuracy: {100 * correct / total:.2f}%')

# ---------- 参数效率对比 ----------
def count_trainable_params(model):
    return sum(p.numel() for p in model.parameters() if p.requires_grad)

if __name__ == '__main__':
    lora_net = LoRANet(rank=4)
    print(f'LoRA可训练参数量: {count_trainable_params(lora_net)}')
    train(lora_net, epochs=3)
    evaluate(lora_net)

    # 对比:全量微调相同结构
    full_net = nn.Sequential(
        nn.Linear(784, 256),
        nn.ReLU(),
        nn.Linear(256, 10)
    )
    print(f'全量微调参数量: {count_trainable_params(full_net)}')
运行方式
pip install torch torchvision
python lora_mnist.py
验证方法与判定标准
- 参数效率验证:运行后观察输出的可训练参数量。LoRA网络(rank=4)可训练参数约为
4×(784+256) + 4×(256+10) = 4×1040 + 4×266 = 5224个,而全量微调网络参数为784×256 + 256 + 256×10 + 10 = 203,530个。LoRA参数量约为全量的2.6%,显著降低训练显存与优化器状态开销。 - 功能正确性:训练3个epoch后,测试集准确率应达到约95%以上(MNIST简单任务,LoRA低秩适配可达到与全量微调相近的精度)。若准确率明显低于90%,说明LoRA实现或超参(rank/alpha)存在问题。
- 收敛性检查:训练loss应逐epoch下降,且最终loss低于0.2(归一化后的交叉熵)。
关键说明
- LoRA核心思想:冻结预训练权重
W,仅训练低秩分解矩阵A(rank×in)和B(out×rank),前向计算时叠加增量ΔW = α/r × BA。本实现中alpha=1.0,实际应用时可调节该缩放系数。 - 本案例使用随机初始化的“预训练”权重(非真实预训练模型),仅用于演示LoRA机制与参数效率。真实场景中应加载预训练权重并冻结,再注入LoRA层进行下游任务微调。
- 代码中
requires_grad=False确保原始权重不参与梯度更新,只有LoRA参数被优化器更新。