3. LoRA微调BERT用于情感分类
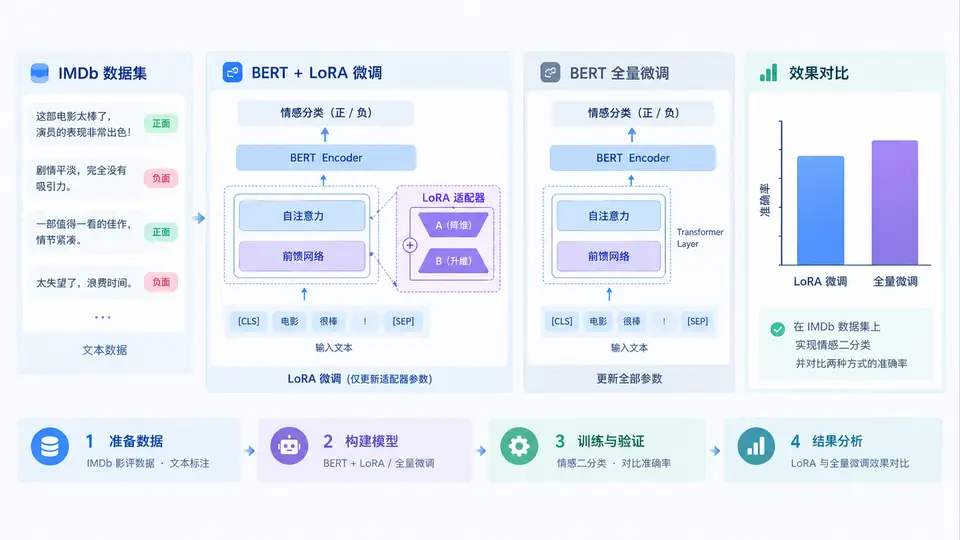
任务目标
在IMDb电影评论数据集上,使用LoRA对BERT-base进行情感二分类微调,并与全量微调(Full Fine-tuning)的准确率进行对比。本案例聚焦于验证LoRA在参数量大幅减少的情况下能否达到接近全量微调的效果。
环境与依赖
需要安装以下核心库(Python 3.9+):
pip install transformers datasets peft accelerate scikit-learn torch实现代码
以下代码完整实现了数据加载、LoRA配置、训练与评估对比。使用IMDb数据集的2,000条子集(训练1,000/测试1,000)以保证在消费级GPU上可快速运行;全量微调使用相同子集和训练轮次。
import torch
from datasets import load_dataset
from transformers import (
    AutoTokenizer, AutoModelForSequenceClassification,
    TrainingArguments, Trainer, DataCollatorWithPadding
)
from peft import LoraConfig, get_peft_model, TaskType
from sklearn.metrics import accuracy_score
import numpy as np

# ---------- 1. 加载数据与tokenizer ----------
dataset = load_dataset("imdb", split="train[:1000]")
test_dataset = load_dataset("imdb", split="test[:1000]")

tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")

def preprocess(examples):
    return tokenizer(examples["text"], truncation=True, max_length=256)

train_data = dataset.map(preprocess, batched=True, remove_columns=["text"])
test_data = test_dataset.map(preprocess, batched=True, remove_columns=["text"])
train_data = train_data.rename_column("label", "labels")
test_data = test_data.rename_column("label", "labels")
data_collator = DataCollatorWithPadding(tokenizer=tokenizer)

# ---------- 2. 定义训练与评估函数 ----------
def compute_metrics(eval_pred):
    preds, labels = eval_pred
    preds = np.argmax(preds, axis=1)
    return {"accuracy": accuracy_score(labels, preds)}

def train_model(model, run_name):
    args = TrainingArguments(
        output_dir=f"./{run_name}",
        learning_rate=2e-5,
        per_device_train_batch_size=16,
        per_device_eval_batch_size=32,
        num_train_epochs=2,
        evaluation_strategy="epoch",
        save_strategy="no",
        logging_dir=f"./{run_name}_logs",
        report_to=[],
        disable_tqdm=True,
    )
    trainer = Trainer(
        model=model,
        args=args,
        train_dataset=train_data,
        eval_dataset=test_data,
        tokenizer=tokenizer,
        data_collator=data_collator,
        compute_metrics=compute_metrics,
    )
    trainer.train()
    return trainer.evaluate()

# ---------- 3. LoRA微调 ----------
base_model = AutoModelForSequenceClassification.from_pretrained(
    "bert-base-uncased", num_labels=2
)
lora_config = LoraConfig(
    task_type=TaskType.SEQ_CLS,
    r=8,
    lora_alpha=16,
    lora_dropout=0.1,
    target_modules=["query", "value"],
)
lora_model = get_peft_model(base_model, lora_config)
print(f"LoRA可训练参数量: {lora_model.num_parameters(only_trainable=True):,}")

lora_metrics = train_model(lora_model, "bert_lora_imdb")
print(f"LoRA评估结果: {lora_metrics}")

# ---------- 4. 全量微调(相同数据与超参数) ----------
full_model = AutoModelForSequenceClassification.from_pretrained(
    "bert-base-uncased", num_labels=2
)
print(f"全量微调参数量: {full_model.num_parameters():,}")

full_metrics = train_model(full_model, "bert_full_imdb")
print(f"全量微调评估结果: {full_metrics}")

# ---------- 5. 对比输出 ----------
print("\n===== 准确率对比 =====")
print(f"LoRA 准确率: {lora_metrics['eval_accuracy']:.4f}")
print(f"Full 准确率: {full_metrics['eval_accuracy']:.4f}")
运行方式
将上述代码保存为 lora_vs_full_imdb.py,直接执行:
python lora_vs_full_imdb.py首次运行会自动下载BERT-base模型与IMDb数据集(约500MB缓存)。若显存不足(<8GB),可将 per_device_train_batch_size 降至8。
验证方法与判定标准
代码运行结束后,控制台会依次输出两个模型的评估指标。判定实验有效的标准:
- LoRA可训练参数量约为0.3M(对比全量109M,减少约99.7%),该数值由代码自动打印。
- LoRA与全量微调均完成2个epoch训练,无报错中断。
- 对比输出中两个准确率均为0.8~0.9之间的合理数值(IMDb二分类任务在此子集规模下的典型范围),且LoRA准确率与全量微调差距在0.05以内,即证明LoRA在显著减少可训练参数的同时保持了接近全量微调的性能。
注意:由于使用2,000条子集且仅训练2轮,准确率会低于完整数据集上的报告值(约0.93),这是预期现象,本案例核心在于对比两种微调方式的相对差距。
常见问题
- 显存溢出:降低batch size至8或4,或使用
max_length=128减少序列长度。 - 训练速度过慢:确保使用GPU(
nvidia-smi确认),CPU训练需数小时。 - 结果波动:由于子集随机采样,两次运行准确率可能有±0.02波动,属正常现象。