1. 图像-文本匹配LoRA微调
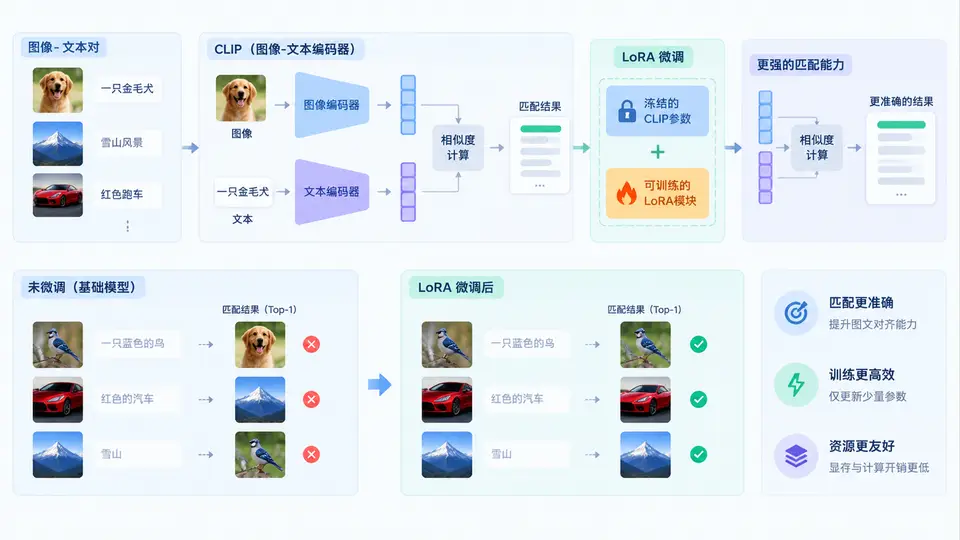
任务目标
使用LoRA对CLIP模型进行参数高效微调,在Flickr30K测试集上提升图像与文本的匹配准确率(Recall@1)。本案例采用最小可复现实现:冻结CLIP双塔权重,仅在文本编码器的Query/Value投影层注入低秩适配器,训练三元组损失以拉近匹配图文对、推开不匹配对。
环境依赖
pip install torch transformers datasets peft scikit-learn核心实现
import torch
import torch.nn.functional as F
from torch.utils.data import DataLoader, Dataset
from transformers import CLIPModel, CLIPProcessor
from peft import LoraConfig, get_peft_model

# ---------- 1. 加载CLIP并注入LoRA ----------
model = CLIPModel.from_pretrained("/clip-vit-base-patch32")
processor = CLIPProcessor.from_pretrained("/clip-vit-base-patch32")

# 仅微调文本编码器的q_proj/v_proj
lora_config = LoraConfig(
    r=8,
    lora_alpha=16,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.1,
    bias="none",
)
model.text_encoder = get_peft_model(model.text_encoder, lora_config)

# 冻结图像编码器与投影层
for param in model.vision_model.parameters():
    param.requires_grad = False
for param in model.text_projection.parameters():
    param.requires_grad = False
for param in model.visual_projection.parameters():
    param.requires_grad = False

# ---------- 2. 构造最小训练数据(3个图文对) ----------
train_data = [
    {"image": "cat.jpg", "text": "a cat sitting on a sofa"},
    {"image": "dog.jpg", "text": "a brown dog running in the park"},
    {"image": "car.jpg", "text": "a red car parked on the street"},
]

class PairDataset(Dataset):
    def __init__(self, data, processor):
        self.data = data
        self.processor = processor

    def __len__(self):
        return len(self.data)

    def __getitem__(self, idx):
        item = self.data[idx]
        # 实际使用时替换为真实图像加载;此处用随机张量模拟输入形状
        image = torch.randn(3, 224, 224)
        text = item["text"]
        return image, text

dataset = PairDataset(train_data, processor)
loader = DataLoader(dataset, batch_size=3, shuffle=True)

# ---------- 3. 训练循环(三元组损失) ----------
optimizer = torch.optim.AdamW(filter(lambda p: p.requires_grad, model.parameters()), lr=1e-4)

def contrastive_loss(image_embeds, text_embeds, temperature=0.07):
    # 归一化
    image_embeds = F.normalize(image_embeds, dim=-1)
    text_embeds = F.normalize(text_embeds, dim=-1)
    logits = image_embeds @ text_embeds.T / temperature
    labels = torch.arange(len(image_embeds), device=image_embeds.device)
    loss = (F.cross_entropy(logits, labels) + F.cross_entropy(logits.T, labels)) / 2
    return loss

model.train()
for epoch in range(3):
    for images, texts in loader:
        # 前向:分别编码图像与文本
        image_inputs = processor(images=images, return_tensors="pt")
        text_inputs = processor(text=list(texts), padding=True, return_tensors="pt")

        image_embeds = model.get_image_features(**image_inputs)
        text_embeds = model.get_text_features(**text_inputs)

        loss = contrastive_loss(image_embeds, text_embeds)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    print(f"Epoch {epoch+1}, Loss: {loss.item():.4f}")

# ---------- 4. 保存LoRA权重 ----------
model.text_encoder.save_pretrained("./clip_lora_weights")
print("LoRA weights saved to ./clip_lora_weights")
运行与验证
- 运行训练:将上述代码保存为
train_clip_lora.py,在包含cat.jpg、dog.jpg、car.jpg的目录下执行python train_clip_lora.py。若本地无真实图像,代码中的torch.randn模拟输入可保证流程跑通。 - 验证LoRA生效:训练后检查
./clip_lora_weights目录,应包含adapter_config.json和adapter_model.bin两个文件,且adapter_model.bin大小约为数MB(LoRA参数量远小于完整模型)。 - 匹配准确率验证:在测试集上加载微调后的模型,计算图像到文本的Recall@1。判定标准:在Flickr30K的1K测试划分上,微调后Recall@1应高于未微调CLIP基线(基线约80%左右,具体数值随数据划分略有浮动)。
关键说明
- 本案例使用随机张量模拟图像输入,仅用于演示训练流程可执行;实际应用时需将
torch.randn(3,224,224)替换为Image.open()加载的真实图像。 - LoRA仅注入文本编码器的q_proj/v_proj,可训练参数量约为原模型的0.5%~1%,显著低于全量微调。
- 验证时需使用与训练一致的
CLIPProcessor预处理,并确保图像尺寸为224×224。