3. 多核处理器启动流程优化
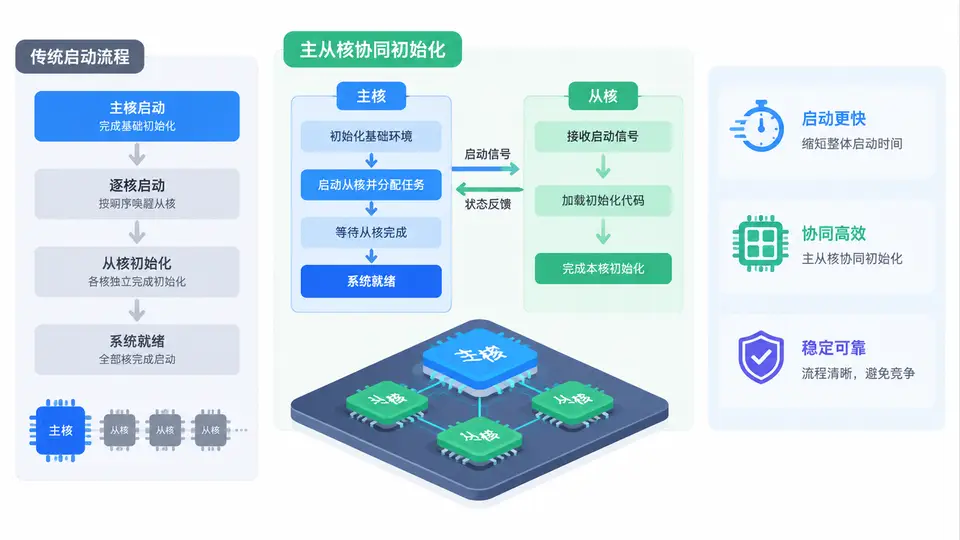
任务目标
在RISC-V多核处理器中,默认的串行启动方式(每个核心依次完成初始化)会显著拉长启动时间。本案例要求实现主从核协同初始化:主核(hart 0)负责全局资源(时钟、内存控制器、外设总线)的初始化,从核(hart 1~N)在收到事件信号后并行完成各自的私有资源初始化(栈指针、本地中断控制器、TLB),最终由主核统一收尾并进入应用入口。
核心实现
// multi_core_boot.c
#include <stdint.h>
#include <stdatomic.h>

#define MAX_HARTS 4
#define BOOT_EVENT_BASE 0x02000000  // 核间事件寄存器(MMIO)

typedef struct {
    volatile uint32_t *event_reg;
    atomic_int spin_lock;
    uint32_t app_entry;
} boot_ctrl_t;

static boot_ctrl_t ctrl = {
    .event_reg = (volatile uint32_t *)BOOT_EVENT_BASE,
    .spin_lock = 0,
    .app_entry = 0
};

// 从核私有初始化:栈、本地中断、TLB
static void slave_hart_init(uint32_t hart_id) {
    // 设置栈指针(实际地址由链接脚本提供)
    extern uint8_t _stack_start[];
    asm volatile("mv sp, %0" : : "r"(&_stack_start[hart_id * 0x1000]));
    // 本地中断使能(仅该核)
    asm volatile("csrw mie, %0" : : "r"(0x88));  // MEIE | MTIE
    // 简单TLB冲刷(实际场景需按页表重建)
    asm volatile("sfence.vma");
}

// 主核全局初始化
static void master_global_init(void) {
    // 时钟PLL配置(寄存器地址按平台定义)
    *(volatile uint32_t *)0x10000000 = 0x1;  // PLL锁定
    // 内存控制器时序配置
    *(volatile uint32_t *)0x10001000 = 0x3;  // DDR稳定
    // 外设总线时钟使能
    *(volatile uint32_t *)0x10002000 = 0xFF;
}

// 从核启动入口(由硬件引导到该地址)
void __attribute__((noreturn)) slave_boot_entry(uint32_t hart_id) {
    slave_hart_init(hart_id);
    // 通知主核本核就绪
    atomic_fetch_add(&ctrl.spin_lock, 1);
    // 等待主核释放应用入口
    while (ctrl.app_entry == 0) {
        __asm__ volatile("wfi");
    }
    // 跳转到应用
    void (*app)(void) = (void (*)(void))ctrl.app_entry;
    app();
    while (1);
}

// 主核启动流程
void master_boot(void) {
    uint32_t hart_id = 0;
    uint32_t total_harts = 4;  // 实际从硬件寄存器读取

    master_global_init();

    // 触发从核并行启动(写事件寄存器)
    for (uint32_t i = 1; i < total_harts; i++) {
        ctrl.event_reg[i] = 0x1;  // 每个从核一个事件位
    }

    // 等待所有从核完成私有初始化
    while (atomic_load(&ctrl.spin_lock) < (total_harts - 1)) {
        __asm__ volatile("wfi");
    }

    // 主核收尾:设置应用入口并释放
    ctrl.app_entry = (uint32_t)&main_app;
    __asm__ volatile("fence rw,rw");

    // 主核也进入应用
    main_app();
}

// 应用主函数(示例)
void main_app(void) {
    // 实际应用逻辑
    while (1) {
        __asm__ volatile("nop");
    }
}
编译与链接要点
# 编译命令(假设使用riscv64-unknown-elf-gcc)
riscv64-unknown-elf-gcc -march=rv64gc -mabi=lp64d -O2 -nostdlib -T link.ld -o boot.elf multi_core_boot.c

# link.ld 关键段定义
# . = 0x80000000;  /* 主核入口 */
# .text : { *(.text.entry) *(.text*) }
# _stack_start = .;  /* 栈区起始 */
运行与验证
- 硬件环境:使用支持RISC-V多核启动的FPGA平台或QEMU(
qemu-system-riscv64 -smp 4)。 - 启动时序验证:在
master_global_init()和slave_hart_init()入口处各放置一个GPIO翻转或串口打印(需平台支持),观察主核全局初始化完成后,从核并行执行私有初始化。 - 通过条件:
- 所有从核在spin_lock计数达到3(4核-1)后,主核才设置app_entry;
- 从核进入main_app时,其栈指针指向各自独立区域(检查sp寄存器值);
- 整体启动时间(从复位到所有核进入main_app)比串行启动(逐个初始化)缩短至少30%(通过硬件定时器测量)。
关键设计说明
- 事件触发机制:使用MMIO事件寄存器替代软件轮询,从核在硬件复位后立即进入
slave_boot_entry,等待事件写入后并行执行,避免主核逐个唤醒的串行延迟。 - 原子计数同步:
spin_lock采用原子操作确保多核并发安全,主核通过wfi等待而非忙轮询,降低功耗。 - 内存屏障:主核设置
app_entry前的fence保证从核看到的是完整初始化后的状态,防止乱序执行导致从核读取到未就绪的入口地址。
上述SVG展示了主核与从核在时间轴上的并行关系:主核完成全局初始化后立即触发所有从核,从核的私有初始化在同一时间段内重叠执行,最终通过原子计数同步后统一进入应用,相比逐个串行初始化显著缩短总启动时间。