3. DEX 文件头与类索引解析
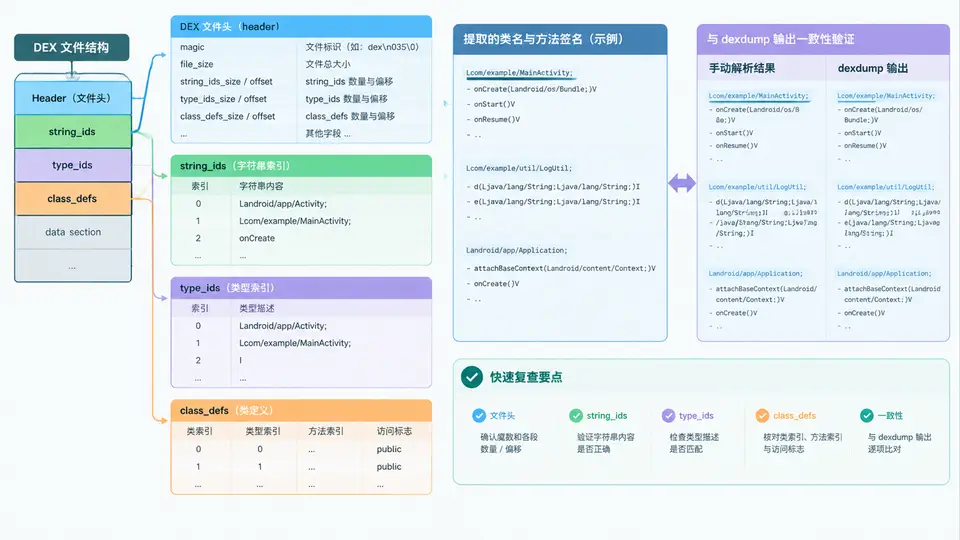
DEX 文件头与索引结构解析
DEX 文件是 Android 应用的核心字节码容器,其头部固定 112 字节,随后依次排列 string_ids、type_ids、proto_ids、field_ids、method_ids 和 class_defs 等索引表。理解这些结构的偏移与数量关系,是手动提取类名与方法签名的前提。
手动解析关键步骤
使用 Python 的 struct 模块按小端序读取 DEX 文件。头部字段的偏移与长度如下表所示:
| 字段 | 偏移 | 长度 | 说明 |
|---|---|---|---|
| magic | 0x00 | 8 | 固定为 "dex\n035\0" 或 "dex\n037\0" |
| checksum | 0x08 | 4 | Adler-32 校验和 |
| signature | 0x0C | 20 | SHA-1 签名 |
| file_size | 0x20 | 4 | 整个 DEX 文件大小 |
| header_size | 0x24 | 4 | 固定 0x70 (112) |
| string_ids_size | 0x38 | 4 | 字符串索引数量 |
| string_ids_off | 0x3C | 4 | 字符串索引表偏移 |
| type_ids_size | 0x40 | 4 | 类型索引数量 |
| type_ids_off | 0x44 | 4 | 类型索引表偏移 |
| proto_ids_size | 0x48 | 4 | 原型索引数量 |
| proto_ids_off | 0x4C | 4 | 原型索引表偏移 |
| method_ids_size | 0x58 | 4 | 方法索引数量 |
| method_ids_off | 0x5C | 4 | 方法索引表偏移 |
| class_defs_size | 0x60 | 4 | 类定义数量 |
| class_defs_off | 0x64 | 4 | 类定义表偏移 |
完整解析脚本
import struct

def read_uleb128(data, offset):
    """读取 ULEB128 编码,返回 (值, 新偏移)"""
    result = 0
    shift = 0
    while True:
        byte = data[offset]
        offset += 1
        result |= (byte & 0x7F) << shift
        if (byte & 0x80) == 0:
            break
        shift += 7
    return result, offset

def parse_dex(filepath):
    with open(filepath, 'rb') as f:
        data = f.read()

    # 1. 解析头部
    magic = data[0:8]
    assert magic[:4] == b'dex\n', "不是有效的 DEX 文件"
    file_size = struct.unpack_from('<I', data, 0x20)[0]
    string_ids_size = struct.unpack_from('<I', data, 0x38)[0]
    string_ids_off  = struct.unpack_from('<I', data, 0x3C)[0]
    type_ids_size   = struct.unpack_from('<I', data, 0x40)[0]
    type_ids_off    = struct.unpack_from('<I', data, 0x44)[0]
    proto_ids_size  = struct.unpack_from('<I', data, 0x48)[0]
    proto_ids_off   = struct.unpack_from('<I', data, 0x4C)[0]
    method_ids_size = struct.unpack_from('<I', data, 0x58)[0]
    method_ids_off  = struct.unpack_from('<I', data, 0x5C)[0]
    class_defs_size = struct.unpack_from('<I', data, 0x60)[0]
    class_defs_off  = struct.unpack_from('<I', data, 0x64)[0]

    print(f"[*] DEX 版本: {magic[4:7].decode()}")
    print(f"[*] 文件大小: {file_size} bytes")
    print(f"[*] string_ids: {string_ids_size} @ 0x{string_ids_off:x}")
    print(f"[*] type_ids:   {type_ids_size} @ 0x{type_ids_off:x}")
    print(f"[*] proto_ids:  {proto_ids_size} @ 0x{proto_ids_off:x}")
    print(f"[*] method_ids: {method_ids_size} @ 0x{method_ids_off:x}")
    print(f"[*] class_defs: {class_defs_size} @ 0x{class_defs_off:x}")

    # 2. 解析 string_ids → 字符串列表
    strings = []
    for i in range(string_ids_size):
        str_off = struct.unpack_from('<I', data, string_ids_off + i * 4)[0]
        # string_data_item: uleb128 utf16_size + MUTF-8 数据
        utf16_len, pos = read_uleb128(data, str_off)
        end = data.index(b'\x00', pos)
        s = data[pos:end].decode('utf-8', errors='replace')
        strings.append(s)

    # 3. 解析 type_ids → 类型描述符
    types = []
    for i in range(type_ids_size):
        descriptor_idx = struct.unpack_from('<I', data, type_ids_off + i * 4)[0]
        types.append(strings[descriptor_idx])

    # 4. 解析 proto_ids → 方法原型
    protos = []
    for i in range(proto_ids_size):
        base = proto_ids_off + i * 12
        shorty_idx, return_type_idx, params_off = struct.unpack_from('<III', data, base)
        protos.append({
            'shorty': strings[shorty_idx],
            'return_type': types[return_type_idx],
            'params_off': params_off
        })

    # 5. 解析 method_ids → 方法签名
    methods = []
    for i in range(method_ids_size):
        base = method_ids_off + i * 8
        class_idx, proto_idx, name_idx = struct.unpack_from('<HHI', data, base)
        methods.append({
            'class': types[class_idx],
            'name': strings[name_idx],
            'proto': protos[proto_idx]
        })

    # 6. 解析 class_defs → 类名
    classes = []
    for i in range(class_defs_size):
        base = class_defs_off + i * 32
        class_idx = struct.unpack_from('<I', data, base)[0]
        classes.append(types[class_idx])

    return strings, types, protos, methods, classes

if __name__ == '__main__':
    strings, types, protos, methods, classes = parse_dex('classes.dex')
    print(f"\n[+] 共解析 {len(classes)} 个类:")
    for c in classes[:10]:
        print(f"    {c}")
    print(f"\n[+] 共解析 {len(methods)} 个方法,前 10 个:")
    for m in methods[:10]:
        params = m['proto']['shorty'][1:]
        print(f"    {m['class']}->{m['name']}({params}) : {m['proto']['return_type']}")
与 dexdump 输出对照验证
运行 dexdump -f classes.dex 可查看头部摘要,dexdump -d classes.dex 输出完整类与方法列表。将脚本输出的 class_defs_size 与 dexdump 头部中的 class_defs_size 对比,将方法签名与 dexdump 的 Class descriptor 和 name 字段逐条核对。
验证要点:
1.
2. 类名数量等于
3. 方法签名中的参数类型与返回类型与 dexdump 的
4. 若 magic 为
1.
string_ids_size 与 dexdump 头部 string_ids_size 一致;2. 类名数量等于
class_defs_size;3. 方法签名中的参数类型与返回类型与 dexdump 的
proto 行一致;4. 若 magic 为
dex\n037\0,需注意 DEX 版本 037 新增的 call_site_ids 等字段不影响本节解析逻辑。
常见错误:
- 偏移读取时未使用小端序
- 字符串解析时未处理 ULEB128 长度前缀,直接按固定长度读取会错位;
- 方法签名中
- 偏移读取时未使用小端序
<,导致数值异常;- 字符串解析时未处理 ULEB128 长度前缀,直接按固定长度读取会错位;
- 方法签名中
class_idx 和 proto_idx 为 2 字节,name_idx 为 4 字节,混用会导致索引错乱。