3. 双向链表实现LRU缓存淘汰
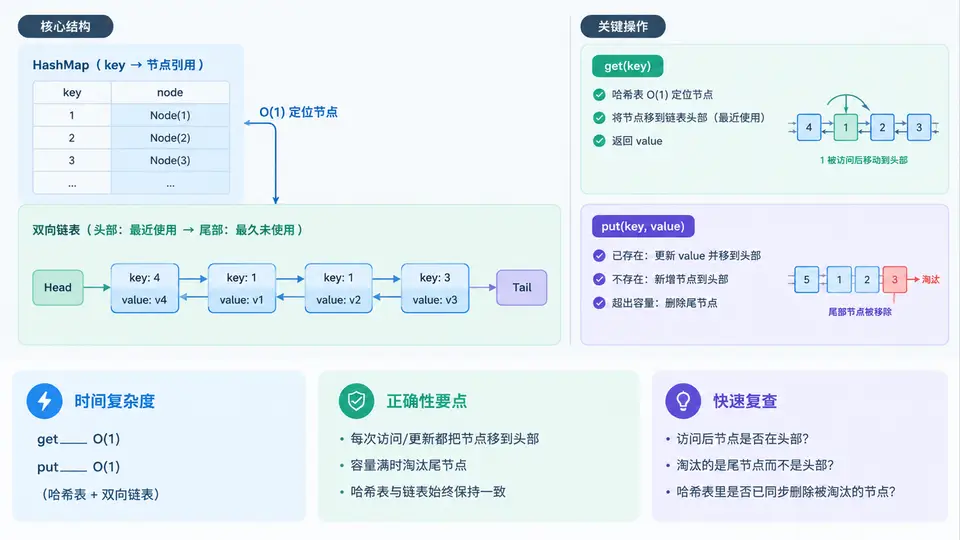
为什么LRU需要哈希表 + 双向链表
LRU(Least Recently Used)淘汰策略的核心要求是:get 和 put 都必须在 O(1) 时间内完成。单独使用一种结构都无法同时满足:
- 只用哈希表:查找是 O(1),但无法维护"最近使用顺序",淘汰时找不到最久未使用的键。
- 只用双向链表:可以把最近使用的节点移到头部、尾部即最久未使用,但按 key 查找节点需要 O(n) 遍历。
把两者组合:哈希表存储 key → 链表节点指针,双向链表按"最近使用程度"排序。哈希表负责 O(1) 定位,双向链表负责 O(1) 调整顺序和删除尾节点。双向链表之所以必须是双向,是因为删除任意节点时需要同时拿到它的前驱和后继,单向链表无法在 O(1) 内完成删除。
节点与缓存类的定义
双向链表节点需要 key、value、prev、next 四个字段。节点中保存 key 是为了在淘汰尾节点时能反查哈希表并删除对应条目——否则拿到节点却不知道它对应哪个 key。
class Node:
    __slots__ = ("key", "value", "prev", "next")
    def __init__(self, key=0, value=0):
        self.key = key
        self.value = value
        self.prev = None
        self.next = None

class LRUCache:
    def __init__(self, capacity: int):
        self.capacity = capacity
        self.map = {}                 # key -> Node
        # 哨兵头尾节点,避免大量边界判断
        self.head = Node()            # head.next 是最近使用
        self.tail = Node()            # tail.prev 是最久未使用
        self.head.next = self.tail
        self.tail.prev = self.head
使用两个哨兵节点(dummy head / dummy tail)是关键工程技巧:插入和删除节点时不需要判断"链表是否为空""是否是头节点""是否是尾节点",所有操作都变成对普通节点的统一处理,显著减少边界 bug。
四个基础链表操作
所有 LRU 逻辑都建立在两个原子操作上:把节点插入到头部(标记为最近使用)和从链表中摘除节点。get 和 put 只是它们的组合。
    def _add_to_head(self, node):
        """把 node 插入到 head 之后,表示最近使用"""
        node.prev = self.head
        node.next = self.head.next
        self.head.next.prev = node
        self.head.next = node

    def _remove(self, node):
        """从链表中摘除 node(不释放,由调用方决定是否复用)"""
        node.prev.next = node.next
        node.next.prev = node.prev

    def _move_to_head(self, node):
        """节点被访问后,移到头部"""
        self._remove(node)
        self._add_to_head(node)

    def _pop_tail(self):
        """淘汰最久未使用的节点并返回"""
        node = self.tail.prev
        self._remove(node)
        return node
注意
_remove 只修改前后指针,不清理 node 自身的 prev/next。如果后续要把该节点重新插入(如 _move_to_head),_add_to_head 会覆盖这两个字段,所以无需手动置空。get 与 put 的 O(1) 实现
get(key):哈希表命中则把节点移到头部并返回 value;未命中返回 -1。
put(key, value):key 已存在则更新 value 并移到头部;key 不存在则新建节点插入头部,若超出容量则淘汰尾节点并从哈希表删除。
    def get(self, key: int) -> int:
        if key not in self.map:
            return -1
        node = self.map[key]
        self._move_to_head(node)      # 标记为最近使用
        return node.value

    def put(self, key: int, value: int) -> None:
        if key in self.map:
            node = self.map[key]
            node.value = value
            self._move_to_head(node)
            return

        node = Node(key, value)
        self.map[key] = node
        self._add_to_head(node)

        if len(self.map) > self.capacity:
            evicted = self._pop_tail()
            del self.map[evicted.key]   # 用节点里的 key 反查删除
两个方法中所有操作——哈希查找、指针调整、字典删除——都是常数时间,因此 get 和 put 均为 O(1)。
验证:操作序列与状态变化
用容量为 2 的缓存执行一组操作,逐步观察链表顺序(左为最近使用)和淘汰行为:
| 操作 | 哈希表 | 链表顺序(head→tail) | 返回值 | 说明 |
|---|---|---|---|---|
| put(1, 10) | {1} | 1 | — | 插入 |
| put(2, 20) | {1,2} | 2 → 1 | — | 2 最近使用 |
| get(1) | {1,2} | 1 → 2 | 10 | 1 被访问,移到头部 |
| put(3, 30) | {1,3} | 3 → 1 | — | 容量满,淘汰 tail 的 2 |
| get(2) | {1,3} | 3 → 1 | -1 | 2 已被淘汰 |
| put(1, 99) | {1,3} | 1 → 3 | — | 更新 1 的值并移到头部 |
| get(3) | {1,3} | 3 → 1 | 30 | 3 被访问,移到头部 |
用下面的断言脚本可以自动验证上述行为:
cache = LRUCache(2)
cache.put(1, 10)
cache.put(2, 20)
assert cache.get(1) == 10        # 1 变为最近使用
cache.put(3, 30)                 # 淘汰 2
assert cache.get(2) == -1        # 2 已淘汰
cache.put(1, 99)                 # 更新 1
assert cache.get(3) == 30        # 3 仍在
assert cache.get(1) == 99        # 1 的值已更新
print("all assertions passed")
常见错误与排查
- 淘汰时忘记删哈希表:只从链表摘除节点,
map中仍保留 key,导致后续 get 返回已淘汰的值,且容量判断失效。必须用evicted.key删除。 - 节点不保存 key:淘汰尾节点时无法知道要删哪个哈希条目,只能遍历哈希表反查,破坏 O(1)。
- put 已存在的 key 时误判容量:更新已有 key 不增加元素数量,不应触发淘汰。代码中先处理"key 已存在"分支再走新增逻辑即可避免。
- 指针顺序写反:
_add_to_head中必须先设置node.next和node.prev,再修改head.next.prev和head.next,否则会丢失原头节点引用。
核心结论:哈希表提供 O(1) 的 key→节点定位,双向链表提供 O(1) 的顺序调整与尾部淘汰,两者通过节点指针耦合,共同实现 get/put 均为 O(1) 的 LRU 缓存。哨兵节点和节点内保存 key 是两个关键的工程细节。