2. 按扩展名自动分类归档文件
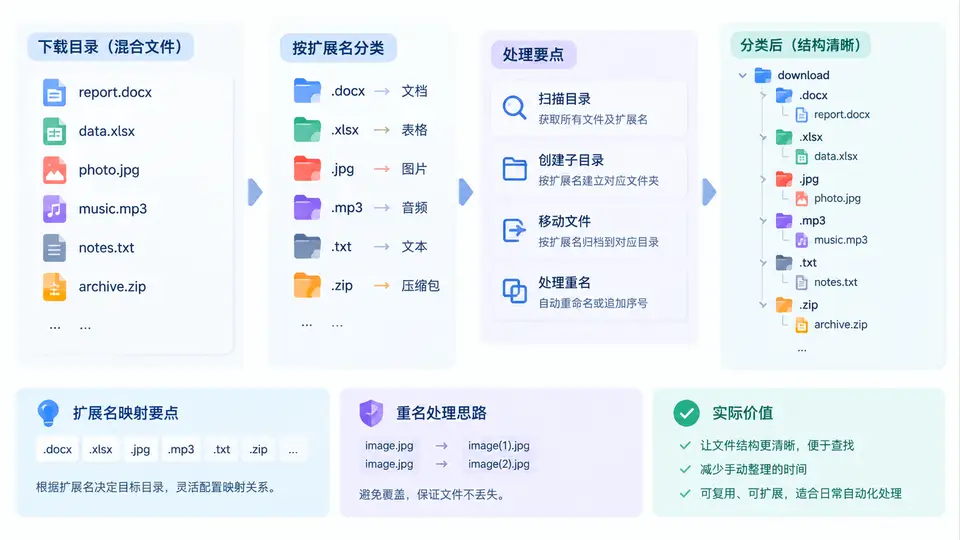
任务拆解:从下载目录到分类归档
下载目录的典型特征是文件类型混杂、命名随机、可能包含同名文件。本案例的目标是:扫描指定目录(默认下载目录),按扩展名把文件移动到对应子目录,并在目标已存在同名文件时自动生成不冲突的新文件名。
核心处理链为:遍历目录 → 提取扩展名 → 确定目标子目录 → 检测重名 → 生成安全文件名 → 移动文件 → 记录归档日志。其中扩展名到子目录的映射、重名冲突的解决策略,是本节需要重点实现的两个环节。
关键实现:扩展名映射与重名处理
下面给出完整可运行的脚本。它使用 pathlib 遍历目录,通过字典完成扩展名到子目录的映射,并用一个 _resolve_conflict 函数处理重名冲突。
from pathlib import Path
import shutil

# 扩展名 → 子目录映射表
EXT_MAP = {
    ".pdf": "文档", ".doc": "文档", ".docx": "文档",
    ".txt": "文档", ".md": "文档",
    ".png": "图片", ".jpg": "图片", ".jpeg": "图片",
    ".gif": "图片", ".bmp": "图片", ".svg": "图片",
    ".mp3": "音频", ".wav": "音频", ".flac": "音频",
    ".mp4": "视频", ".avi": "视频", ".mkv": "视频",
    ".zip": "压缩包", ".rar": "压缩包", ".7z": "压缩包",
    ".tar": "压缩包", ".gz": "压缩包",
}

def resolve_conflict(target: Path) -> Path:
    """若目标文件已存在,则追加 _1, _2 ... 直到不冲突"""
    if not target.exists():
        return target
    stem, suffix = target.stem, target.suffix
    parent = target.parent
    counter = 1
    while True:
        candidate = parent / f"{stem}_{counter}{suffix}"
        if not candidate.exists():
            return candidate
        counter += 1

def archive_files(source_dir: str, dry_run: bool = False):
    src = Path(source_dir)
    if not src.is_dir():
        raise NotADirectoryError(f"目录不存在: {source_dir}")

    moved, skipped = [], []

    for item in sorted(src.iterdir()):
        if not item.is_file():
            continue

        ext = item.suffix.lower()
        subdir_name = EXT_MAP.get(ext, "其他")
        dest_dir = src / subdir_name
        dest_dir.mkdir(exist_ok=True)

        dest = resolve_conflict(dest_dir / item.name)

        if dry_run:
            print(f"[预览] {item.name} → {subdir_name}/{dest.name}")
        else:
            shutil.move(str(item), str(dest))
            print(f"[移动] {item.name} → {subdir_name}/{dest.name}")

        moved.append((item.name, f"{subdir_name}/{dest.name}"))

    print(f"\n完成:共处理 {len(moved)} 个文件")
    return moved

if __name__ == "__main__":
    # 将此处替换为你的下载目录路径
    archive_files(r"C:\Users\YourName\Downloads", dry_run=True)
先预览再执行:脚本提供
dry_run=True 参数,先打印移动计划而不实际移动文件。确认映射关系和重名处理符合预期后,再改为 dry_run=False 执行真实移动。
重名冲突的三种策略对比
| 策略 | 处理方式 | 优点 | 风险 |
|---|---|---|---|
| 追加序号 | 报告.pdf → 报告_1.pdf | 不丢失任何文件,可追溯 | 文件名变长,需记录映射 |
| 覆盖 | 直接覆盖同名文件 | 目录整洁 | 数据丢失,不可逆 |
| 跳过 | 保留源文件不动 | 安全 | 源目录残留文件,需二次处理 |
本案例采用追加序号策略,兼顾安全性与自动化程度。若需要回滚能力,可在移动时同步写入映射日志(参考批量重命名案例中的日志思路)。
验证与边界情况
- 验证方法:执行后检查下载目录下是否生成「文档/图片/音频/视频/压缩包/其他」子目录,且每个文件出现在对应目录中。
- 无扩展名文件:
item.suffix返回空字符串,会归入「其他」目录。 - 大小写扩展名:使用
.lower()统一处理,.PDF和.pdf映射到同一目录。 - 隐藏文件:以
.开头的文件(如.gitignore)也会被处理,如需跳过可加判断if item.name.startswith("."): continue。 - 目标目录已存在:
mkdir(exist_ok=True)保证重复执行不报错。
注意:移动操作不可逆。首次运行务必使用
dry_run=True 预览,确认无误后再执行真实移动。建议先在测试目录中验证脚本行为。