1. 数据平台CI/CD现状梳理与流水线边界定义
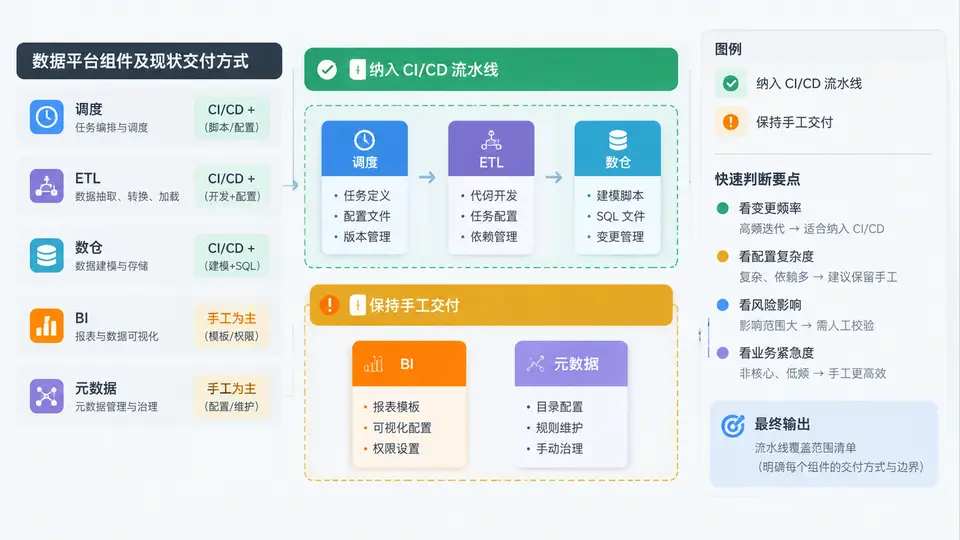
盘点对象与交付方式
数据平台的交付单元并不只有代码。调度配置、ETL脚本、数仓模型、BI报表、元数据定义这五类资产,各自的变更频率、影响范围和回滚难度差异很大,因此不能一刀切地全部塞进流水线。先按“变更载体”把它们拆开看:
- 调度:DAG定义、依赖关系、调度周期、告警规则,通常以配置文件或代码形式存在,变更后需要重新发布到调度引擎。
- ETL:SQL脚本、Python作业、Shell脚本,直接操作数据,变更影响下游表。
- 数仓:表结构DDL、分区策略、生命周期、数据质量规则,变更可能破坏下游查询。
- BI:报表定义、数据集、仪表板布局,变更影响业务用户看到的数字。
- 元数据:表注释、字段血缘、Owner信息,变更影响数据发现和治理。
对每一类资产,需要回答三个问题:当前怎么交付?变更后怎么验证?出问题怎么回滚?这三个问题的答案决定了它是否适合纳入CI/CD。
流水线边界判定
把“是否纳入流水线”拆成两个维度来判断:变更是否可自动化验证,以及回滚是否可自动化执行。两个维度都满足的环节,优先纳入;只满足一个的,纳入但保留人工确认卡点;都不满足的,保持手工并记录原因。
| 资产类型 | 当前交付方式 | 可自动验证 | 可自动回滚 | 建议边界 |
|---|---|---|---|---|
| 调度DAG | 手工导入调度平台 | 是(语法+依赖检查) | 是(版本回退) | 纳入CI/CD |
| ETL SQL | 手工执行或脚本跑 | 是(语法+试运行) | 部分(需备份) | 纳入,加人工确认 |
| 数仓DDL | DBA手工执行 | 是(Schema对比) | 难(数据已写入) | 纳入CI,CD人工 |
| BI报表 | BI平台手工发布 | 部分(数据集校验) | 是(版本回退) | 纳入,加业务确认 |
| 元数据 | 手工维护 | 弱(无强制校验) | 是(覆盖写) | 暂不纳入,先规范 |
边界定义的核心不是“能不能做”,而是“值不值得做”。元数据虽然可回滚,但缺少自动验证手段,强行纳入流水线只会增加维护成本,不如先统一元数据录入规范。
覆盖范围清单
基于上面的判定,输出一份可直接执行的覆盖范围清单。清单需要明确每个环节的触发条件、验证手段和回滚方式,避免“纳入流水线”变成一句空话。
流水线覆盖范围清单(示例)

1. 调度DAG
   触发:DAG文件变更提交到主干
   验证:语法解析 + 依赖环检测 + 调度周期冲突检查
   回滚:调度平台版本回退到上一稳定版本
   卡点:无

2. ETL SQL
   触发:SQL文件变更提交到主干
   验证:语法检查 + 在影子环境试运行 + 行数波动阈值检查
   回滚:恢复上一版本SQL,重跑受影响分区
   卡点:试运行结果需人工确认

3. 数仓DDL
   触发:Schema定义文件变更
   验证:与生产Schema对比 + 下游影响分析
   回滚:不自动回滚,需DBA评估后手工处理
   卡点:CD阶段必须人工审批

4. BI报表
   触发:报表定义文件变更
   验证:数据集字段校验 + 关键指标抽样对比
   回滚:BI平台版本回退
   卡点:业务方确认指标口径

5. 元数据
   触发:暂不纳入流水线
   验证:无
   回滚:不适用
   卡点:先统一录入规范,后续再评估
现状与目标边界对照
下面的SVG把五类资产的当前交付方式、判定结果和目标边界放在同一张图上,便于快速看清哪些环节需要改造、哪些保持现状。
落地建议
这份清单不是一次性的。建议每季度重新评估一次,尤其是元数据这类“暂不纳入”的环节,随着元数据管理工具成熟,验证手段补齐后可以重新纳入。另外,ETL和BI虽然纳入了流水线,但人工卡点的存在意味着流水线不能全自动跑到底,需要在CD阶段设置审批节点,避免未经确认的变更直接触达生产。
数仓DDL的CD阶段必须保留人工审批,因为表结构变更一旦执行,即使回滚DDL,已经写入的数据也无法自动恢复。建议在CI阶段增加下游影响分析,列出所有依赖该表的作业和报表,作为审批依据。