2. Kafka 多节点集群搭建与副本分配验证
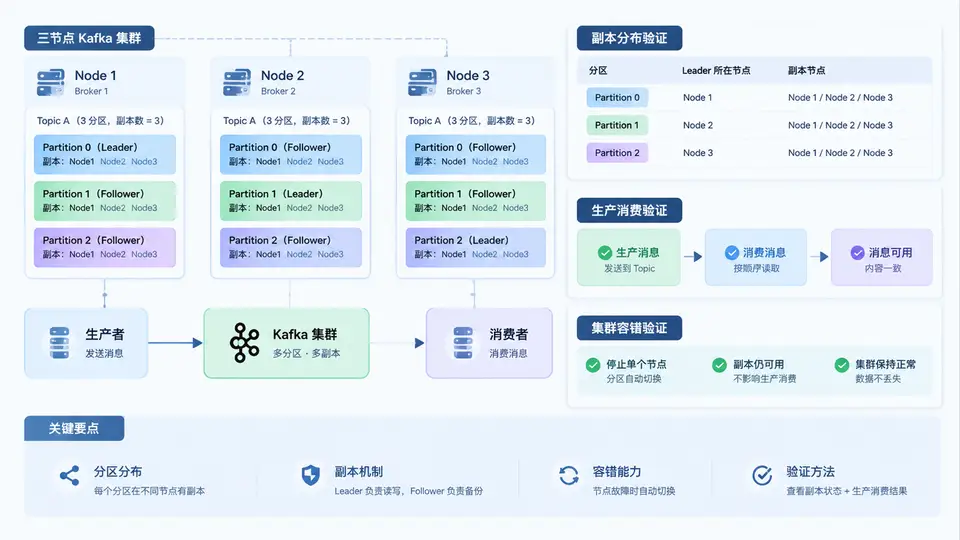
集群拓扑与副本分布设计
三节点 KRaft 集群需要为每个 broker 分配唯一的 node.id,并让三个节点同时承担 broker 与 controller 角色。关键配置项如下:
process.roles=broker,controller:每个节点同时参与元数据仲裁与消息存储。controller.quorum.voters=1@k1:9093,2@k2:9093,3@k3:9093:三节点共同构成 controller 仲裁组,必须完全一致。listeners与advertised.listeners:客户端入口用 9092,controller 通信单独用 9093,避免混用。log.dirs:每个节点使用独立数据目录,便于观察各自的日志段与副本文件。
下面这张图给出三节点集群的连接关系、端口分工,以及一个 replication-factor=3 主题在三个 broker 上的分区副本落点。Leader 副本负责读写,Follower 副本持续拉取同步;任一 broker 下线时,其上的 leader 分区会由 ISR 中的 follower 接管。
三节点配置与启动
在 k1、k2、k3 三台主机上分别准备 Kafka 二进制包,解压到 /opt/kafka。每台机器的 config/kraft/server.properties 只需改动 node.id、advertised.listeners 和 log.dirs 三处,其余保持一致。以 k1 为例:
# k1: config/kraft/server.properties
process.roles=broker,controller
node.id=1
controller.quorum.voters=1@k1:9093,2@k2:9093,3@k3:9093
listeners=PLAINTEXT://0.0.0.0:9092,CONTROLLER://0.0.0.0:9093
advertised.listeners=PLAINTEXT://k1:9092
controller.listener.names=CONTROLLER
listener.security.protocol.map=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
log.dirs=/data/kafka-logs
num.partitions=3
default.replication.factor=3
min.insync.replicas=2
offsets.topic.replication.factor=3
transaction.state.log.replication.factor=3
transaction.state.log.min.isr=2
k2 与 k3 仅需把 node.id 改为 2、3,advertised.listeners 改为 k2:9092、k3:9092,log.dirs 改为各自数据目录。三台机器都要保证 controller.quorum.voters 完全一致,否则仲裁组无法形成。
首次启动前,只需在任意一个节点生成一次集群 ID,然后把该 ID 写入三个节点的 meta.properties:
# 在 k1 上执行一次
CLUSTER_ID=$(/opt/kafka/bin/kafka-storage.sh random-uuid)
echo "cluster id: $CLUSTER_ID"

# 三个节点分别格式化(使用同一个 CLUSTER_ID)
/opt/kafka/bin/kafka-storage.sh format -t $CLUSTER_ID -c /opt/kafka/config/kraft/server.properties
格式化完成后,在三个节点上分别启动 broker:
/opt/kafka/bin/kafka-server-start.sh -daemon /opt/kafka/config/kraft/server.properties
# 查看启动日志确认无 ERROR
tail -n 50 /opt/kafka/logs/server.log
创建带副本主题并验证分布
集群启动后,创建一个 3 分区、3 副本的主题,并查看其分区副本落点:
/opt/kafka/bin/kafka-topics.sh --bootstrap-server k1:9092 \
  --create --topic orders-topic \
  --partitions 3 --replication-factor 3

/opt/kafka/bin/kafka-topics.sh --bootstrap-server k1:9092 \
  --describe --topic orders-topic
预期输出中每个分区都会显示一个 leader 和两个 replicas,且 Isr 应包含全部三个 broker。例如:
Topic: orders-topic  Partition: 0  Leader: 1  Replicas: 1,2,3  Isr: 1,2,3
Topic: orders-topic  Partition: 1  Leader: 2  Replicas: 2,3,1  Isr: 2,3,1
Topic: orders-topic  Partition: 2  Leader: 3  Replicas: 3,1,2  Isr: 3,1,2
如果 Isr 少于 3 个,说明有 follower 未完成同步,需要检查对应 broker 的日志与网络连通性。
生产消费与容错验证
先向主题写入一批消息,再从另一个节点消费,确认跨节点读写正常:
# 生产
seq 1 100 | /opt/kafka/bin/kafka-console-producer.sh \
  --bootstrap-server k1:9092 --topic orders-topic

# 从 k2 消费
/opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server k2:9092 --topic orders-topic \
  --from-beginning --max-messages 100 | wc -l
接下来验证容错:停掉 k1,观察分区 leader 是否自动切换,并确认生产消费仍可继续。
# 停止 k1 上的 broker
/opt/kafka/bin/kafka-server-stop.sh

# 在 k2 上重新查看主题描述
/opt/kafka/bin/kafka-topics.sh --bootstrap-server k2:9092 \
  --describe --topic orders-topic
此时原本 leader 在 k1 上的分区(如 P0)应变为由 k2 或 k3 接管,Isr 中不再包含 1。继续向主题写入消息并消费,应仍然成功。恢复 k1 后,它会重新加入 ISR,但不会自动抢回 leader 身份,除非触发优先副本选举。
kafka-topics.sh --describe 中的 Isr 与 Replicas 是否一致。若长期不一致,优先检查 broker 间 9092 端口连通性、磁盘空间以及 num.replica.fetchers 是否过小。min.insync.replicas=2 的写入条件,生产者会收到 NOT_ENOUGH_REPLICAS 异常。这是预期行为,不是配置错误。集群健康检查清单
| 检查项 | 命令或观察点 | 通过标准 |
|---|---|---|
| Broker 注册 | kafka-broker-api-versions.sh --bootstrap-server k1:9092 | 列出 1、2、3 三个 broker |
| Controller 仲裁 | 各节点日志中 QuorumController 无反复选举 | 稳定选出 leader controller |
| 主题副本分布 | --describe --topic orders-topic | 每个分区 Replicas 含 3 个 broker,Isr 与 Replicas 一致 |
| 跨节点生产消费 | 从 k1 生产、k2 消费 | 消息条数一致,无超时 |
| 单节点故障切换 | 停 k1 后重新 describe | leader 自动迁移,Isr 变为 2 个 |
| 故障恢复 | 重启 k1 后再次 describe | Isr 恢复为 3 个 |