1. CALPHAD热力学数据库文件结构解析与最小体系建模
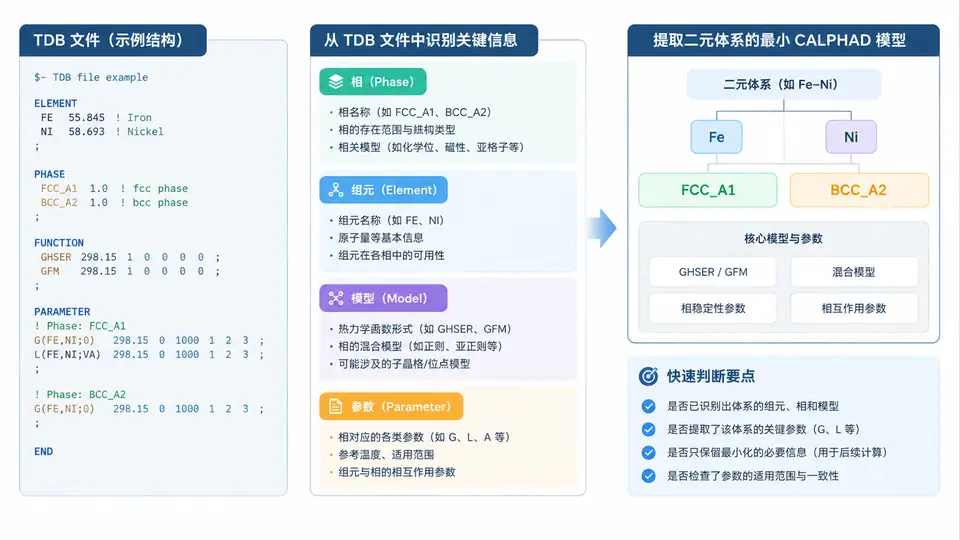
从 TDB 文本到可计算模型:先看清文件骨架
TDB(Thermo-Calc Database)文件本质是一份“分命令块组织的热力学模型清单”。解析时不要逐行硬读,而要先按命令关键字切块,再在块内提取对象。一个最小二元体系的 TDB 通常包含以下命令块:
ELEMENT:声明组元及其参考态(如 SER 标准态),是后续所有能量的基准。SPECIES:声明化学物种,简单置换固溶体可省略。PHASE:声明相名、晶体结构类型、亚点阵数及每个亚点阵的占位组元。CONSTITUENT:给出每个相的亚点阵组元列表,决定模型自由度。PARAMETER:给出相互作用参数(G、L、TC、BMAGN 等)的表达式与温度区间。FUNCTION:定义可被参数引用的自定义函数(如温度多项式)。TYPE_DEFINITION:定义 GES 命令类型,控制参数书写格式。
解析顺序建议:先读 ELEMENT 建立组元索引 → 再读 PHASE/CONSTITUENT 建立相与亚点阵结构 → 最后读 PARAMETER/FUNCTION 把能量表达式挂到对应相上。这样任何一条参数都能被唯一地定位到“相 + 亚点阵 + 组元组合 + 温度区间”。
最小二元体系的 TDB 关键片段
下面给出一个可被 Thermo-Calc 读取的最小 A–B 二元置换固溶体 TDB 骨架。它只保留后续计算必需的对象:两个组元、两个相(液相与 FCC)、每个相的置换亚点阵、以及纯组元与相互作用参数。
ELEMENT A  FCC_A1  2.0000E+01  0.0  0.0  !
ELEMENT B  FCC_A1  5.0000E+01  0.0  0.0  !

PHASE LIQUID  %  1  1.0  !
CONSTITUENT LIQUID  :A,B:  !

PHASE FCC_A1  %A  2  1  1.0  !
CONSTITUENT FCC_A1  :A,B:  !

PARAMETER G(LIQUID,A;0)  298.15  +GHSERAL#;  6000  N !
PARAMETER G(LIQUID,B;0)  298.15  +GHSERB#;   6000  N !
PARAMETER G(LIQUID,A,B;0) 298.15  -20000+5*T; 6000  N !

PARAMETER G(FCC_A1,A;0)  298.15  +GHSERAL#;  6000  N !
PARAMETER G(FCC_A1,B;0)  298.15  +GHSERB#;   6000  N !
PARAMETER G(FCC_A1,A,B;0) 298.15  -10000+3*T; 6000  N !

FUNCTION GHSERAL#  298.15  -7976.15+137.093*T-24.3672*T*LN(T)
   +1.88466E-03*T**2-8.77664E-07*T**3+74092*T**(-1);  6000  N !
FUNCTION GHSERB#   298.15  -10500+120.5*T-20.0*T*LN(T);  6000  N !
解析要点:每条
PARAMETER 的括号内是“相名, 组元组合; 阶数”。例如 G(LIQUID,A,B;0) 表示液相中 A–B 相互作用的零阶 Redlich–Kister 参数 L₀。分号后的数字是阶数,不是温度区间编号。温度区间写在参数表达式之后、以分号分隔,最后以 N 或 Y 结束。
用 Python 提取最小模型
下面的脚本读取 TDB 文本,按命令块切分,输出组元、相、亚点阵与参数清单。它不依赖任何第三方库,可直接运行。
import re

def parse_tdb(path):
    text = open(path, encoding="utf-8", errors="ignore").read()
    # 去掉注释行(以 $ 开头)与空行
    lines = [ln.strip() for ln in text.splitlines()
             if ln.strip() and not ln.strip().startswith("$")]
    blocks = []
    cur = None
    for ln in lines:
        m = re.match(r"^([A-Z_]+)\s+(.*)$", ln)
        if m and m.group(1) in {
            "ELEMENT","SPECIES","PHASE","CONSTITUENT",
            "PARAMETER","FUNCTION","TYPE_DEFINITION"}:
            if cur: blocks.append(cur)
            cur = {"cmd": m.group(1), "body": m.group(2)}
        elif cur:
            cur["body"] += " " + ln
    if cur: blocks.append(cur)
    return blocks

def extract_model(blocks):
    elements, phases, constituents, params = [], {}, {}, []
    for b in blocks:
        cmd, body = b["cmd"], b["body"]
        if cmd == "ELEMENT":
            elements.append(body.split()[0])
        elif cmd == "PHASE":
            name = body.split()[0]
            phases[name] = body
        elif cmd == "CONSTITUENT":
            name = body.split()[0]
            subl = re.findall(r":([^:]+):", body)
            constituents[name] = [s.split(",") for s in subl]
        elif cmd == "PARAMETER":
            params.append(body)
    return elements, phases, constituents, params

blocks = parse_tdb("minimal.tdb")
els, phs, cons, prms = extract_model(blocks)
print("组元:", els)
print("相:", list(phs.keys()))
for p, c in cons.items():
    print(f"  {p} 亚点阵: {c}")
print("参数条数:", len(prms))
for p in prms:
    print("  ", p[:70])
运行后应得到类似输出:组元 ['A','B'],相 ['LIQUID','FCC_A1'],每个相一个亚点阵 [['A','B']],参数条数 6。若参数条数少于预期,通常是 PARAMETER 跨行导致 body 拼接不完整,可检查续行是否被正确合并。
最小模型的完整性检查
| 检查项 | 通过条件 | 不通过时的典型原因 |
|---|---|---|
| 组元闭合 | 所有相中出现的组元都在 ELEMENT 中声明 | 拼写不一致或遗漏 ELEMENT |
| 亚点阵组元 | CONSTITUENT 中每个亚点阵非空 | 冒号配对错误 |
| 纯组元参数 | 每个相的每个亚点阵组元都有 G(相,组元;0) | 缺少端元 Gibbs 能 |
| 相互作用参数 | 二元体系至少有一条 L₀ | 只写了纯组元参数 |
| 温度区间 | 参数覆盖目标计算温度 | 区间上限低于计算温度 |
常见陷阱:TDB 中
PHASE 行的 % 或 %A 是结构类型标记,不是注释;CONSTITUENT 的冒号必须成对出现,否则亚点阵解析会错位。另外,FUNCTION 名以 # 结尾时,在 PARAMETER 中引用也要带 #,否则会被当作未定义符号。
可直接使用的解析检查清单
- □ 用正则按命令关键字切块,保留跨行拼接。
- □ 建立
element → SER 参考态映射。 - □ 建立
phase → [亚点阵组元列表]映射。 - □ 对每条 PARAMETER 解析出:相名、组元组合、阶数、温度区间、表达式。
- □ 校验每个相的每个端元都有 G 参数。
- □ 校验二元相互作用参数至少存在 L₀。
- □ 确认参数温度区间覆盖后续计算温度(如 300–2000 K)。
完成以上步骤后,你就得到了一个可用于后续相图计算、热力学性质计算的最小 CALPHAD 模型对象,而不是一份只能阅读的文本文件。